
Firebaseエミュレータの代替Firenookを公式と比べて検証|20万件で差が開くリスナー付きの書き込みとクエリ、ルールの違いと乗り換えの判断
Firebaseエミュレータの代替Firenookが紹介され、速さと動作を公式と比較
Firebaseエミュレータの代替を目指すオープンソースのツールFirenookの開発元が、2026年11月5日にHacker Newsで紹介しました。Rustで書かれていてJavaが要らず、firebase.json とSDKとポートはそのままで使えるとしています。Googleとは関係のない独立したプロジェクトで、ライセンスはApache 2.0、最新版は11月4日(UTC)の0.2.1です。
Firebaseエミュレータは、FirestoreやAuthをローカルで動かしてアプリを開発・テストするための公式ツールです。開発元は、データが増えるとメモリが足りなくなり、そのときデータも失われることを不満に挙げ、書き込みが40倍速く、メモリは10分の1と公表しています。この数字は、0.2.0を使い、サーバー1台で21万件のデータと2時間の実アプリの通信を流して測ったものです。公式側はメモリが足りずスワップを使っていたと開発元が書いていて、自分の負荷で測るよう勧めています。
この記事は、Firebaseエミュレータを開発やCIで使っていて、乗り換えを考えている人に向けたものです。同じ条件のコンテナで公式とFirenookに同じ負荷をかけ、速さ、メモリ、動作を比べました。どんなプロジェクトで乗り換えると効果が大きいのか、どんなときは公式のままにするのかを判断できるようにまとめます。
記事の要点
データが多いコレクションにリスナーを開くプロジェクトほど、差が大きく出た
2026年11月7日、firebase-tools 15.35.0 と Firenook 0.2.1 を同じ条件のコンテナで比べた結果です。
差が大きかった操作
同じコレクションにリスナーを開いた書き込み
20万件・リスナー5本で、書き込み1回が公式は約6.4秒、Firenookは0.5ミリ秒未満でした。
差が小さかった操作
単純な書き込みと読み取り
リスナーがなければ書き込みの差は約2〜3倍で、IDでの読み取りはほぼ同じでした。20万件のまとめて書き込みは公式が速くなりました。
動作の違い
36項目は同じ、ルールに違いあり
よく使う36項目の結果はそろいました。一方で、報告されているルールの違いは手元でも4件再現しました。
同じコレクションにリスナーがあると、公式の書き込みは大きく遅くなった
今回の比較で最も差が開いたのは、絞り込みのリスナーを開いたまま同じコレクションへ書き込む操作です。リスナーは、データの変更を受け取り続ける接続で、チャットや一覧の画面でよく使います。公式のエミュレータは、リスナーの本数と文書の数が増えるほど書き込みが遅くなり、Firenookはほぼ変わりませんでした。測ったのは書き込みが完了するまでの時間で、この条件でリスナーに通知が届くまでの時間は測っていません。
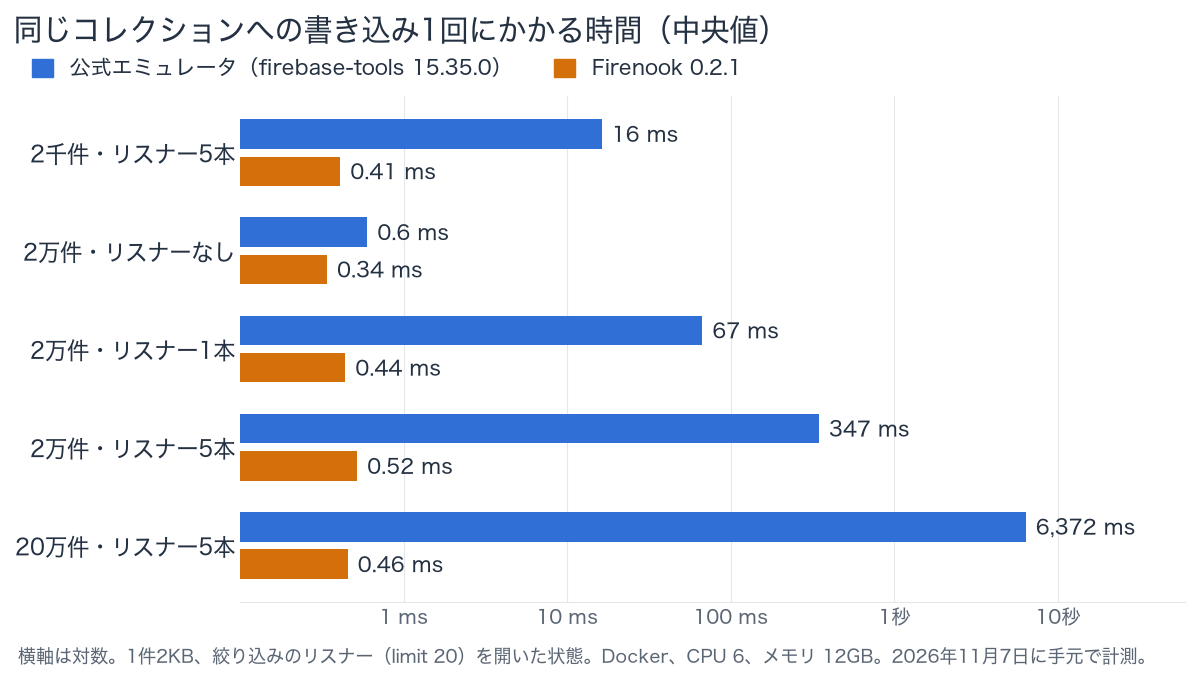
リスナーがないときの公式は0.6ミリ秒で、十分に速く動きます。2万件でリスナーが1本あると67ミリ秒、5本で約350ミリ秒になりました。遅くなったのは、書き込み先と同じコレクションに絞り込みのリスナーがあるときです。別のコレクションに開いたリスナー10本や、文書1件を見るリスナーでは、公式の書き込みは1ミリ秒前後でした。テストで大量のデータを入れて同じコレクションにリスナーを開く場合や、本番に近い量の試験データで開発する場合に、この差が待ち時間として現れます。
約2万2千件でも起動とメモリとクエリに差が出た
データが約2万2千件までの結果です。起動と待機中のメモリ、クライアントSDKの2行とリスナーの行は、データを入れる前の値です。書き込みの差は測り方で約2〜5倍の幅がありました。開発元の40倍はリスナーを開いた実アプリの通信で測った値で、この表とは条件が違います。IDでの読み取りと、文書1件を見るリスナーへの通知は、ほぼ同じです。
| 操作(約2万2千件まで) | 公式 | Firenook | Firenookから見た差 |
|---|---|---|---|
| 起動(ポートが開くまで、データなし) | 3.0 秒 | 0.12 秒 | 約25倍速い |
| 待機中のメモリ(データなし) | 636 MB | 100 MB | 約6分の1 |
| 2万2千件を入れたあとのメモリ | 972 MB | 210 MB | 約5分の1 |
| 書き込み(Admin SDK、1件800バイト) | 0.58 ms | 0.20 ms | 約3倍速い |
| 書き込み(クライアントSDK、ルールあり、データを入れる前) | 1.3 ms | 0.27 ms | 約5倍速い |
| まとめて書き込み(2万件) | 0.42 秒 | 0.37 秒 | ほぼ同じ |
orderBy と limit 20 | 29 ms | 2.9 ms | 約10倍速い |
where と limit 50 | 68 ms | 3.4 ms | 約20倍速い |
| IDで1件読む(クライアントSDK、ルールあり、データを入れる前) | 3.0 ms | 3.3 ms | ほぼ同じ |
| 文書1件を見るリスナーへの通知(データを入れる前) | 3.8 ms | 4.0 ms | ほぼ同じ |
| Authのユーザー作成 | 0.47 ms | 0.35 ms | 約1.3倍速い |
| Storageへ1MBのアップロード | 12 ms | 9.5 ms | 約1.3倍速い |
「データを入れる前」の3行は、20万件の試験の冒頭、起動の直後に2回ずつ測った値の中間です。この3行は、別のコレクションにリスナーを10本開いた状態で測っています。ほかの行は、公式とFirenookを交互に3回ずつ実行した中央値です。Dockerのコンテナ(node:24-trixie、CPU 6、メモリ 12GB、macOS 27.0.1のApple Silicon)で実行しました。公式はfirebase-tools 15.35.0、Firestoreエミュレータ 1.22.0、OpenJDK 21.0.13です。
この結果は、1台のMac上のDockerで、各2〜3回測ったものです。公式のJavaは既定の設定で動かしました。既定のヒープの上限はコンテナのメモリの4分の1なので、公式のメモリの値はこの設定でも変わります。マシンやデータの形が変われば、数字も変わります。
テストの実行でよく使う emulators:exec は、Firestoreだけを起動して短いスクリプトを1本走らせて終了するまでが、公式の5.3秒に対してFirenookは0.27秒でした(1回の計測)。起動1回で約5秒の差なので、CIの効果は起動の回数に約5秒を掛けて見積もれます。
20万件ではクエリとメモリの差がさらに広がった
1件2KBの文書を20万件入れて測りました。入れる文書のサイズも、約2万2千件の試験の800バイトから変えています。クエリとメモリと再起動の差が広がり、まとめて書き込む速さ、文書1件を見るリスナーへの通知、ディスクの使用量では公式が上回りました。
| 操作(20万件、1件2KB) | 公式 | Firenook | Firenookから見た差 |
|---|---|---|---|
| 20万件のまとめて書き込み(6本並列) | 2.6 秒 | 5.3 秒 | 公式が約2倍速い |
| 読み込みとクエリのあとのメモリ | 約2.2 GB | 約240 MB | 約9分の1 |
| 書き込み(クライアントSDK、ルールあり、別のコレクションへ1件800バイト) | 0.57 ms | 0.31 ms | 約1.8倍速い |
orderBy と limit 20 | 約420 ms | 3.1 ms | 約130倍速い |
where と limit 50 | 約1.3 秒 | 3.1 ms | 約400倍速い |
| IDで1件読む(Admin SDK) | 3.0 ms | 3.0 ms | 同じ |
| 別のコレクションの文書1件を見るリスナーへの通知 | 3.0 ms | 4.1 ms | 公式が約1.3倍速い |
| 再起動してデータが読めるまで | 10.4 秒 | 0.37 秒 | 約28倍速い |
| 保存に使うディスク | 404 MB(エクスポート) | 942 MB | 公式のほうが小さい |
2回の結果の中間。公式は --export-on-exit と --import、Firenookは --keep-data で再起動しました。メモリはエミュレータの関連プロセスのRSSの合計です。クライアントSDKの書き込みと文書1件のリスナーは、20万件とは別のコレクションで測りました。このとき、さらに別のコレクションにリスナーを10本開いています。
開発元の文書によると、公式はデータをJavaのメモリに置き、Firenookはディスクに置きます。手元の結果もこの説明に沿っていて、公式のメモリは件数とともに増え、Firenookは240〜270MBにとどまりました。手元の12GBの環境では、公式がメモリ不足で止まることはありませんでした。20万件を6本並列で入れる操作とディスクの使用量では、Firenookが不利でした。データをディスクに残す設計の影響と考えられますが、原因までは確かめていません。
もう1つの違いは、強制終了したときのデータです。プロセスを kill -9 で止めると、公式は終了時のエクスポートが作られず、次の起動で文書もユーザーもファイルも0件でした(公式で途中のデータを残すには、emulators:export を別に実行します)。Firenookは --keep-data を付けていれば、書き込みの2秒後に止めたデータがすべて残りました。どちらも1回の試験です。
よく使う36項目は同じ、報告されたルールの違いは手元でも再現
速くても動きが違えば、テストの結果を信じられません。そこで、同じスクリプトをNode.jsのAdmin SDKとWeb SDKから両方に実行し、戻り値とエラーコードを比べました。36項目の結果は同じです。エラーの文面は比べていません。主な項目は次のとおりです。
| 比べた操作 | 結果 |
|---|---|
| Auth: 作成、ログイン、誤ったパスワードのエラー、カスタムクレーム、IDトークンの検証、カスタムトークン | 同じ |
セキュリティルール: 許可と拒否、get() を使う条件、型とキーの検証 | 同じ |
書き込み: 同時トランザクション20本、increment などの更新、存在しない文書の更新、重複の作成 | 同じ |
クエリ: 複数フィールドの範囲、in、not-in、カーソル、集計、コレクショングループ、or | 同じ |
| リスナーの通知(追加、変更、削除)、Timestampの小数部 | 同じ |
| Storage: アップロード、ルールによる拒否、ダウンロード、一覧、メタデータ | 同じ |
| Functions: HTTP関数、Firestoreのトリガー | 同じ |
データの移し替えも試しました。文書400件(Timestamp、GeoPoint、参照、Bytesを含む)、サブコレクション、ユーザー1人、ファイル1つを、公式でエクスポートしてFirenookで読み込み、Firenookからのエクスポートを公式へ読み込む逆方向も行いました。文書全体のハッシュは一致し、ユーザーとファイルも読めました。公式へ戻せるので、試してから元に戻す判断もできます。
一方で、0.2.1には公式と違う動きの報告があります。11月6日に利用者がルールの違いを7件報告していて、そのうち4件を手元で試すと、報告と同じ結果でした。
| ルールや操作 | 公式 | Firenook 0.2.1 |
|---|---|---|
三項演算子(a ? b : c)を含むルール | 動く | 起動時にエラーで止まる |
関数の return の行末に ; がないルール | 動く | 起動時にエラーで止まる |
文字列の添字(s[0])を使うルール | 読み取りを許可 | permission-denied で拒否 |
| ルールが拒否する、存在しない文書の更新 | permission-denied | not-found |
試していない報告の中には、公式なら拒否するクエリを許可するという内容もあります。緩い方向の違いは、テストが通っても本番で失敗する原因になりえます。7件のうち6件には修正のプルリクエストが出ています。5件は報告者から(2件は下書き)、三項演算子の件は別の利用者からです。11月8日の時点で、どれもマージされていません。いま挙げたクエリの件には、修正のプルリクエストがまだありません。開発元のプルリクエストでも、0.2.1はiOSとWebのSDKの確認で公式との差があり、その修正を進めていると書かれています。その中には、Web SDKで接続を使い回してリスナーを開いた直後に書くと、書き込みが確定しないまま止まる場合があるという内容も含まれます(60回の試験で4回、別の実行では38回)。手元の試験はリスナーを開いて少し待ってから書いているので、この場面は確かめていません。手元の36項目はNode.jsのSDKだけで、ブラウザとモバイルのSDKは含みません。開発元の互換性の文書も、公式のエミュレータをすべて置き換えられる段階にはまだ達していないと書かれています。
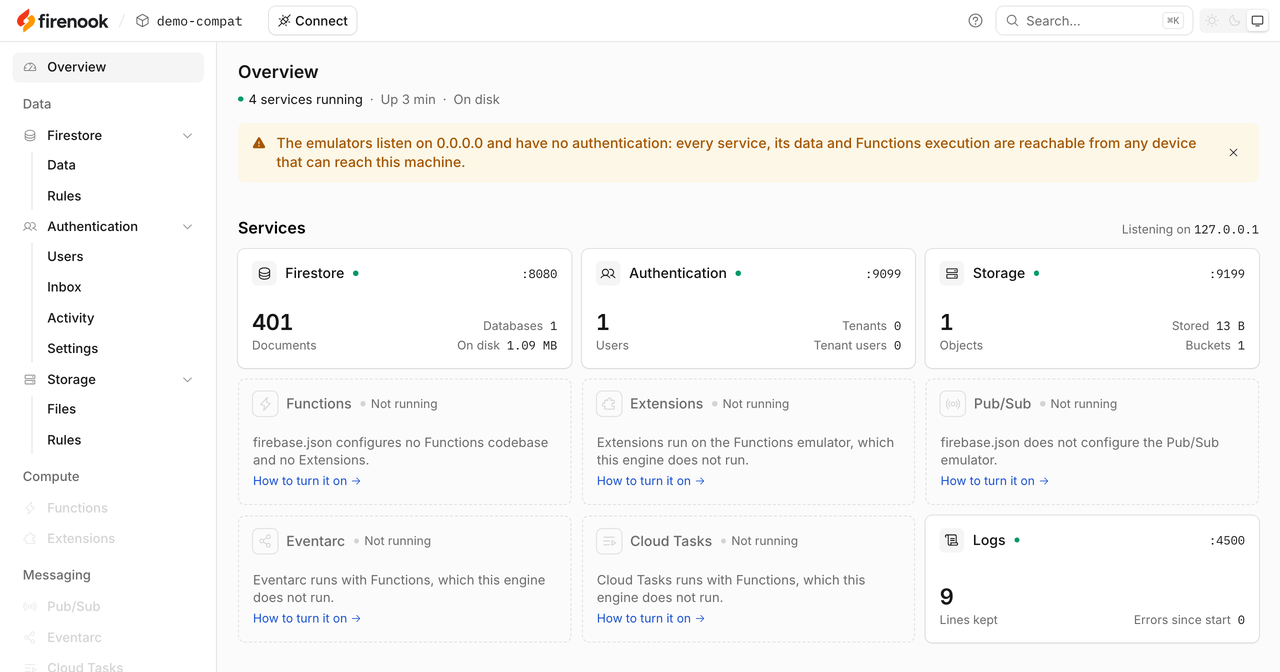
/console)で、試験データの件数を確かめた画面。Firenook 0.2.1、2026年11月7日。コンテナの外から開くために 0.0.0.0 で待ち受けたので、上部に警告が出ています。乗り換えが向くプロジェクトと公式のままがよいプロジェクト
乗り換えの効果が大きい
数万件以上のコレクションにリスナーを開く、CIで何度も起動する
同じコレクションに数万件以上あり、絞り込みのリスナーを開いたまま書き込む開発やテストに向きます。リスナーを開いた直後に書くテストは、何度か繰り返して結果を確かめます。起動の差が積み重なるCIや、Javaを入れたくない環境にも向きます。手元でもJavaを外した環境でFirenookだけが起動しました。
公式のままにする
対象外のサービスやランタイムを使う
Realtime Database、Hosting、App Hosting、Data ConnectはFirenookにありません。手元でも firebase.json に書いたRealtime DatabaseとHostingは、警告を出して起動せず、ポートも開きませんでした。開発元の文書によると、FunctionsのPythonとDartのランタイムも対象外で、LinuxはAlpineに対応していません。
まず少し試す
セキュリティルールのテストに頼っている
0.2系のツールで、コミットの大半は1人の開発者によるものです。まず自分のルールファイルが読み込めるかを確かめます。ルールのテストは公式エミュレータでも走らせ続けると、判定の違いに気づけます。ブラウザやモバイルのSDKを使うプロジェクトは、実際のブラウザや実機でも確かめます。
導入の大きさも違います。手元で量ると、Firenookは node_modules で69MBです。公式はfirebase-toolsが264MB、エミュレータのJARが181MB、Javaの実行環境が195MBでした。ただし、デプロイやログインの機能はFirenookにないので、firebase-toolsは本番へのデプロイのために残します。
既存のプロジェクトで試す手順
手元のサンプルで確かめた手順です。Firenookの必要な環境はNode 22、24、26で、手元はNode 24です。--dry-run は変更の内容だけを表示します。手元のサンプルで init --adopt が足したのは .firebaserc だけで、firebase.json は変わりませんでした。.firebaserc がないまま試すときは、npx firenook emulators:start --project demo-名前 のように指定します。
npm install --save-dev firenook

# 変更の内容を表示する(設定は変えない)
npx firenook init --adopt --dry-run
# 表示された内容を書き込む
npx firenook init --adopt

# 公式のエクスポートを読み込み、次の起動へデータを残す
npx firenook emulators:start --import ./data --keep-data

# テストを走らせて終了する(--only は使うサービスに合わせる)
npx firenook emulators:exec --only firestore "npm test"

# 公式へ戻すときに書き出す(起動中に別のターミナルで)
npx firenook emulators:export ./data-from-firenook
試すときは次の4点を確かめます。
--importと--keep-dataの組み合わせ: 2回目以降も同じ指定で起動します。手元では、--importを外すとnative state refusedと表示されて起動しませんでした。同じ指定で再起動すると、あとから足したデータも残っていました。--keep-dataの有無: 付けないと、手元では次の起動にデータが持ち越されませんでした。.firenookのフォルダ: 作業データが.firenook/runsの下に起動ごとに残り、ログには自動で削除しないと表示されます。診断の記録に文書のデータや認証のクレームが入る場合があるとも表示されるので、.gitignoreに入れ、不要になったら消します。記録が不要なら--no-diagnosticsを付けます。開発元は、合成した試験データで使うよう勧めています。- 待ち受けるアドレス: エミュレータには認証がありません。
firebase.jsonのhostは127.0.0.1のままにします。
まずローカルの開発でFirenookを使い、自分のテストが同じように通るかを見ます。次にCIをFirenookへ移し、ルールのテストなど一部のジョブは公式エミュレータで走らせ続けます。結果に差が出なければ、Firenookで走らせるジョブを増やします。この順番なら、差が出たときに公式へ戻しやすいと思います。自分のプロジェクトの効果を知るには、開発元も勧めているとおり、自分のデータとリスナーの本数で測るのが確実です。
参考資料
- Firenook、firenook-dev/firenook(Apache 2.0、0.2.1は2026年11月4日、UTC): 概要、対応サービス、導入手順
- Firenook「Benchmarks」: 開発元の計測の条件と数値
- Firenook「Compatibility」: 対応範囲と対象外
- Firenook issue #138〜#144(2026年11月6日): ルールの違いの報告。プルリクエスト #151: SDKの確認で見つかった差の修正
- Hacker Newsの紹介(2026年11月5日): 開発元の説明
- Firebase「Install, configure and integrate Local Emulator Suite」(2026年11月7日閲覧): 公式の
--importと--export-on-exit