
サブエージェントを本体へまとめるとAIエージェントはどう変わるか|Anthropicの指針と、公開された実行記録で分かった速さと答え漏れ
Anthropicが、サブエージェントを本体のAIへまとめる指針を公開した
Anthropicは2026年10月22日、AIエージェントを作る開発者向けの記事「Building agents: When to fold subagents into your main agent loop」を公開しました。対象は、受付役のAIが問い合わせを読み、注文担当や返品担当といった別々のAI(サブエージェント)へ仕事を振り分ける構成です。記事は、この構成をどんなときに「1つのAIが必要な手順書と道具をその場で読み込みながら最後まで対応する構成」へまとめるかを説明しています。この記事では、客との会話を最後まで受け持つAIを「本体」と呼びます。
記事と対になる移行用のキットsingle-agent-loop-kitも、GitHubで公開されています(最初のコミットは10月21日、ライセンスはApache-2.0)。キットには、架空の家電小売店のサポート窓口を題材に、返品担当を本体へまとめる前と後をAnthropicのAIモデル(claude-opus-5)で実際に動かした記録が入っています。キットの説明文書では、測った数値とそこから引き出した所見が省かれていて、結果は記録ファイルから読み取る形になっています。
この記事では、指針が挙げる「まとめる理由」と「サブエージェントを残す条件」を整理し、キットの記録ファイルを筆者が集計し直した結果から、応答が速くなった問い合わせと、答えが欠けた問い合わせを具体的に見ていきます。
この記事の要点
キットの例では、返品担当を本体へまとめると応答が速くなった一方、必要な確認を飛ばす回も出た
Anthropicの指針
まず1つのループで作る
担当を分けるのは、資料が多すぎて精度が落ちるときなど3つの条件に当てはまる場合。
返品の問い合わせ
平均30秒→9秒
返品担当を本体へまとめた版。AIを呼び出す回数も平均6回から3.3回に減った。
配送と返品を同時に頼む問い合わせ
2回とも合格に
変更前は2回とも返品の手続きをせずに終わり、不合格だった。
配送状況の問い合わせ
2回中1回で配送日が抜けた
まとめた版の本体が、配送の確認を飛ばして答えた。
数値は、キット同梱の実行記録(2026年10月8日、claude-opus-5、12種類の問い合わせを各2回)を筆者が集計し直したもの。
受付役と6つの担当で動く構成を、1つのAIのループへまとめる
先に、記事で比べる2つの構成を確認します。キットの題材は、Tamberwick Homeという架空の家電小売店のサポート窓口です。客は「注文5002の状況は?」「やかんを返品したい」「掃除機が赤く点滅する」といった問い合わせを送ります。
変更前の窓口では、受付役のAIが問い合わせを読み、注文、配送、返品、会員情報、機器の診断、保険の請求という6つの担当AIのどれかへ仕事を渡します。担当AIはそれぞれ自分用の指示文と道具を持ち、調べた結果を要約して受付役へ返し、受付役が客への返事を書きます。保険の請求だけは、担当AIが客と直接やり取りする引き渡しの形です。
指針が勧める構成では、1つのAIが会話の最初から最後までを受け持ちます。このAIは、ツールを呼んで結果を読み、次の手を決めることを、答えが出るまで繰り返します。指針はこの繰り返しを「ループ」と呼んでいます。返品の手順のような仕事のやり方は「スキル」(必要になったときだけ読み込む手順書)にし、注文の照会や返品の登録は「ツール」(AIが呼び出せる機能)にします。返品の期限のように必ず守らせる規則は、AIへの指示文ではなくツールのプログラム側で強制します。
変更前
受付役+6つの担当AI
- 受付役が問い合わせを読み、担当を選ぶ
- 担当AIが自分の道具で調べ、結果を要約して返す
- 受付役が要約を読んで客へ返事を書く
担当ごとに指示文と持ち主がいる。担当をまたぐと、要約の受け渡しが増える。
指針が勧める形
1つのAIのループ+スキルとツール
- 同じAIが計画を立て、必要なツールをまとめて呼ぶ
- ツールの結果をそのまま同じAIが読み、次の手を決める
- 答えるか、上限(回数・費用)に達したら止まる
手順はスキル、守らせる規則はツールの中へ。担当を残す場合は、本体がツールとして呼ぶ。
1つのループが有利になる3つの理由
指針はまず、大きな組織で起きやすい問題を挙げています。チームごとに担当AIを作り、その上に中央チームが受付役を置くと、受け渡しのたびに細かな情報が落ち、担当が増えて持ち主の分からないものが出てきます。各チームが受付役の指示文へ規則を書き足した結果、互いに矛盾する指示文を、記事は「Frankenprompt」と呼んでいます。ある顧客では、1つのループにした版が複数の担当を使う版より約2倍速く動いたと書かれています。
そのうえで、1つのループが有利になる理由として次の3つを挙げています。
理由1
すべての結果を同じAIが見る
担当AIの要約を通さず、ツールの結果を直接読むので、別々の調べものの結果を結び付けて答えられる。
理由2
手順書は必要なときだけ読む
スキルとツールは最初は短い説明だけを見せ、使うときに全文を読み込む。Anthropicは、この方法も使って、新しいモデル向けのClaude Codeのシステムプロンプトを80%以上短くした。
理由3
モデルが1つのループで扱える量が増えた
Opus 4.5以降のモデルは多くの判断を1つのループで扱える。担当を固く分けた構成は、新しいモデルへの切り替えも妨げる。
計画の立て方も変わります。指針では、最初のターンで同じAIが計画を書き、ツールの結果を見ながら書き直します。計画を書いたAIがそのまま実行するので、途中で方針を変えられる、というのが記事の説明です。
サブエージェントを残すのは、3つの条件に当てはまるとき
指針は、サブエージェントが役立つ場面も明記しています。検証、並行作業、権限の分離では担当を分ける利点があり、Anthropic自身も調査用のシステムで複数のエージェントを使っています。残す、または足す目安として挙げているのは次の3つです。
サブエージェントを残す・足す3つの条件
- 資料が増えて精度が落ちたと測れたとき: 1つのループに読ませる資料が多すぎて、評価の点数が実際に下がる。
- 並行して調べる仕事があるとき: 互いに独立した調べものを、終わったら捨てる新しい作業領域で同時に進めたい。
- 1つのAIが道具を選べなくなったとき: ツールが多すぎて選び間違える、または指示文の中に矛盾がある。指針は、ツール定義が30〜50個を超えると選択が悪くなりやすいと書いている。
分けるときは、組織図や問題の種類ではなく「どの資料を読むか」で分け、担当には短い結果だけを返させる。
キットの例でも、保険の請求担当は残す判定になっています。外部の保険会社が指示文を管理し、請求の記録は客と保険会社の担当AIとの会話そのものである必要がある、という設定です。機器の診断担当は、900行ある機器ログを毎回読むので、本体へまとめずに「ツールとして呼ぶ」判定でした。
キットの実行記録では、返品の問い合わせが約3分の1の時間になった
キットには、Claude Codeがキットの手順に沿って返品担当を本体へまとめた変更(差分ファイル付き)と、その前後に12種類の問い合わせを2回ずつ流した記録が入っています。この変更でまとめたのは返品担当だけで、注文、配送など残る5つの担当はそのまま残っています。返品の手順をスキルにし、「返品できる注文か」の判定を返品登録のツールの中へ移し、受付役が返品のツールを自分で呼んで客へ答えられるようにしました。受付役が、返品については本体として動く形です。
筆者は、記録ファイル(results.jsonl)に入っている各回の合否、応答時間、AIの呼び出し回数、トークン数を、自作のPythonスクリプトで集計し直しました。キットに同梱されたプログラムは使わず、記録の数値だけから計算しています。
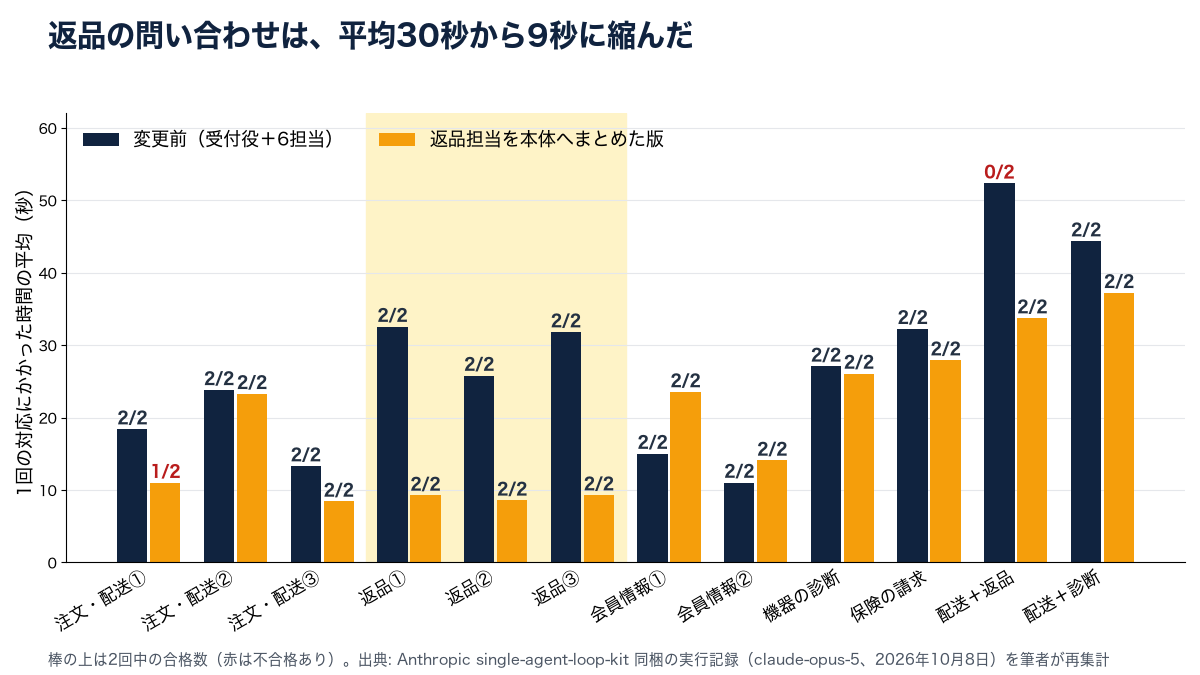
返品の3種類の問い合わせは、平均30.0秒から9.0秒になりました。変更前は受付役が返品担当を呼び、返品担当が調べて要約を返し、受付役が返事を書き直していたため、AIの呼び出しが平均6回かかっていました。まとめた版では平均3.3回です。
合格(全24回)
22→23回
平均の応答時間
27.3→19.4秒
AIの呼び出し回数
平均6.3→4.8回
1回あたりのトークン
ほぼ同じ
約19,700→約19,300
全体でも応答時間は短くなり、トークン数はほぼ同じでした。機器の診断を含む問い合わせは900行のログを読むために1回で7万トークンを超え、全体の平均を押し上げています。返品の3種類だけを見ると、1回あたり約9,000トークンが約6,800トークンに減っていました。
合否で変わったのは、「注文5002が10月2日までに届かないなら、注文5001のやかんを返品したい」という、配送と返品をまたぐ問い合わせです。到着予定は10月3日なので、条件どおりなら返品の手続きに進みます。変更前は2回とも、到着予定を伝えたうえで「待つか返品するか」の選択肢を並べ、返品を登録せずに終わっていました。まとめた版では2回とも返品を登録し、返品番号を伝えています。Claude Codeがキットの手順で変更前の窓口を点検した記録(PLAN.md)は、受付役の指示文にあった「ほかの質問があっても、返品の依頼はまず返品担当へ回す」という返品チームの規則が、この問い合わせのように2つの用件を含む依頼とぶつかると指摘していました。
速くならなかった問い合わせもあります。グラフの「会員情報①」(配送先住所の変更)は、まとめた版の2回目でAIを8回呼び、33.6秒かかりました。記録が2回ずつなので、1回の外れ値が平均を大きく動かします。
速くなった版で、配送日を答え漏らした回があった
「注文5002の状況は?」という最も単純な問い合わせ(グラフの「注文・配送①」)で、まとめた版は2回中1回不合格になりました。採点の条件は、配送中であることと、到着予定日(10月3日)を答えに含めることです。
合格した1回目
本体が注文を調べたあと、配送担当に追跡番号で到着予定を確かめさせ、「Northwayで配送中、アルバニーの中継拠点を出発済み、到着予定は10月3日」と答えた。
不合格の2回目
本体が注文を1回調べただけで答え、「発送済みで追跡番号はTRK-77002。配達日の記録はまだない。配送チームに確認しましょうか」と返した。配送担当は呼ばれなかった。
回答の英文を筆者が要約・和訳。キット同梱の実行記録(2026年10月8日、claude-opus-5)。
変更前の2回は、どちらも注文担当のあとに配送担当が呼ばれていました。まとめた版では、返品の手続きのために注文を調べるツールを本体が直接持つようになり、配送の問い合わせにもそのツールを使っています。注文の記録には配達日の欄が空のまま入っているため、それを見て「配達日の記録はまだない」と答えた回が出ました。指針にも、本体が注文を調べるツールを持って自分で答えてしまい、配送担当に到着予定を聞かなくなった例が書かれていて、その壊れ方は2回中1回しか現れなかったとあります。キットの記録は、この説明と同じ経過をたどっています。
同じ答え漏れは、翌日に別の変更(機器の診断担当をツールとして呼ぶ変更)を試した記録でも、変更後の2回中1回で起きていました。このときは受付役が注文担当だけを呼んで答えています。本体が注文のツールを直接持たない構成でも、配送の確認を飛ばした答えが出ています。キットを試した人はこの問い合わせを含む2種類を変更前と変更後で4回ずつ追加で流し、この問い合わせは8回とも合格したのを確かめてから変更を残しました。この実行の説明文書は、2回ずつの比較では判断するには少なすぎたと振り返っています。
自分のエージェントで試すときは、テストを先に作って1つずつまとめる
指針とキットの手順をまとめると、移行は次の順で進めます。どの段階でも、同じテストで前後を比べ、数字が保たれた変更だけを残します。
1. 合否を自動で採点するテストを作る
最終的な答えと実際に行った操作を採点する。指針は約10件の正解例から始めればよいとしている。
2. いつも続けて動く担当を1つにまとめる
キットの例では、配送担当は必ず注文担当の直後に呼ばれていた。
3. 残す担当は、本体がツールとして呼ぶ
会話は本体が持ち続ける。客と直接話す必要がある担当だけを、会話ごと引き渡す。
4. 担当を1つずつ、スキルとツールへ移す
指示文はスキルへ、外部APIの呼び出しはツールへ移し、必ず守らせる規則はツールの中で判定する。
5. 各問い合わせを何回も流して比べる
守らせたい規則と、担当をまたぐ流れのすべてにテストを用意し、1回の結果で残すかどうかを決めない。
キットのREADMEによると、例の窓口はAPIキーなしで配線だけを確かめる無料のチェックができ、実際のモデルで流す前には止まり、トークン数の見積もりを示す手順になっています。自分のシステムに使う場合も、監査の後、有料の実行の前、変更前の採点の後、変更ごとに止まって確認を求める作りです。
キットの記録を見る限り、まとめた効果がはっきり出たのは、担当を経由するたびにAIの呼び出しが増えていた返品の問い合わせでした。担当を減らす前に、自分の窓口で呼び出し回数が多い流れと、確認を飛ばされると困る規則を書き出しておくと、どこから手を付けるかと、どのテストを足すかが決まります。