
Claude Codeなど3つのコーディングエージェントを同じAIモデルで比べた研究|正答率の差は小さく、1問あたりの費用は最大3倍違った
山東大学の研究者が、3つのコーディングエージェントに同じAIモデルを載せて比べた
中国・山東大学のYangze Liu氏とZhongyi Han氏が、Claude Code、OpenCode、mini-SWE-agentという3つのコーディングエージェントを、同じAIモデルと同じ課題で比べた論文「What Does a Harness Buy? Tokens, Mostly」を、2026年10月3日に論文公開サイトのarXivへ投稿しました。IT業界のニュースサイトVentureBeatが10月23日に紹介記事を出しています。
コーディングエージェントは、AIがリポジトリのファイルを読み、コマンドを実行し、コードを書き換えて不具合の修正まで進めるツールです。中で考えるAIモデルは差し替えられるため、「どのツールを使うか」と「どのモデルを使うか」は別々に選べます。この研究は、モデルを固定してツールだけを替えると、正答率と費用がどれだけ変わるかを測りました。
この記事では、比べた条件、正答率と費用の結果、費用の差が生まれた仕組みを説明します。論文と一緒に公開された実験データを使って、合格数と費用を手元で計算し直した結果も載せます。
研究の要点
同じAIモデルなら、エージェントを替えても正答率の差は小さく、1問あたりの費用は最大3倍違った
正答率
差は5ポイント以内
447問で比べたClaude Codeとmini-SWE-agentの差。OpenCodeはmini-SWE-agentより最大9ポイント低かった。
正解・不正解が入れ替わった問題
どちらも約13%
難しい45問で、エージェントを替えたときと、同じ設定でやり直したときの割合が同じだった。
費用
最大3倍の差
毎回AIへ送る固定の前置きの長さと、作業の手数で決まった。
エージェントの違いは、AIモデルへ渡す指示・道具・会話の整理の仕方
論文は、AIモデルの外側にあるこの仕組みを「ハーネス」と呼んでいます。ハーネスが受け持つのは、作業の進め方を書いた指示文(システムプロンプト)、AIが呼び出せる道具(ファイル編集やコマンド実行)、長くなった会話を要約して詰める処理の3つです。以下では、ハーネスの違いを「エージェントの違い」として説明します。
比べた3つは、作りの規模が大きく違います。AIへ最初に送る固定の前置き(指示文と道具の説明)の長さを論文が数えると、Claude Codeは16,581トークン、OpenCodeは7,025トークン、mini-SWE-agentは829トークンでした。トークンは、AIが文章を区切って数える単位です。
Claude Code
Anthropic製。今回は2.1.259〜2.1.273を使用
固定の前置き
16,581トークン
ファイル編集や検索など、呼び出せる道具が多い。出力が途中で切れると続きを書かせる。
OpenCode
オープンソース。今回は1.18.30と1.18.31
固定の前置き
7,025トークン
1回の出力の上限は3万2千トークン。上限で切れると、その時点で作業が終わる。
mini-SWE-agent
研究用の最小構成。今回は2.4.6
固定の前置き
829トークン
道具はコマンドを実行する1つだけで、会話を詰める処理もない。
課題には、実在するPythonのオープンソースから集めた不具合の修正問題「SWE-bench Verified」を使いました。エージェントが直したコードを、その問題用のテストで採点します。全500問から一つのリポジトリの8問を除いた492問を、人が解くと1時間以上かかる難しい45問と、残りの447問に分けています。
AIモデルは、研究者が自分のサーバーで動かしたQwen3.6-35B-A3BとQwen3.8-27B、各社のAPIで呼び出したDeepSeek-V4-Flash、GLM-5.3-Flash、HY4-Previewの5つです。Claude Opus 5もClaude Codeの中でだけ走らせ、上位モデルの目安にしています。インターネットにつながる状態では、AIが元の修正をGitHubで探し当ててしまう試行が多かったため、採点に使った試行はすべてネットワークを遮断しています。ここでの「試行」は、1つのエージェントに1問を1回解かせることを指します。
正答率の差は小さく、偶然を超えたのはOpenCodeの約9ポイントだけ
447問では、2つのQwenモデルについて3つのエージェントを比べました。Claude Codeとmini-SWE-agentの正答率は、どちらのモデルでも5ポイント以内に収まっています。
| AIモデル | Claude Code | mini-SWE-agent | OpenCode |
|---|---|---|---|
| Qwen3.6-35B-A3B | 69.7%(310/445) | 71.5%(318/445) | 66.6%(297/446) |
| Qwen3.8-27B | 78.2%(347/444) | 79.3%(353/445) | 70.1%(312/445) |
OpenCodeだけはQwen3.8-27Bで約9ポイント低く、論文はこれを、偶然のぶれを超えて確認できた唯一の差としています。原因の半分ほどは、1回の出力の上限(3万2千トークン)でした。上限で返答が切れたとき、OpenCodeは続きを書かせずに作業を終えるため、途中までの修正しか残りません。Qwen3.8-27Bの447問では、この形で失敗した試行がOpenCodeで33件、続きを書かせるClaude Codeでは1件でした。
難しい45問では、5つのモデルで3つのエージェントを比べ、同じ設定をもう一度実行した結果とも突き合わせました。エージェントを替えると、正解と不正解が入れ替わる問題は約13%ありました。同じエージェントのまま解かせ直したときも、入れ替わる割合は約13%でした(どちらも組み合わせごとの値の中央値)。45問でエージェントを替えて見えた差は、やり直しで生じる差と区別できない大きさです。
エージェントの差を見分けるのに必要な問題数(論文の試算)
45問で比べた場合
正答率に13ポイントの差があっても、検出できるのは2回に1回程度。
447問で比べた場合
約5ポイントの差まで見分けられる。
数十問のベンチマークで「このエージェントのほうが何ポイント高い」と比べた結果を見るときは、同じ設定でやり直した結果も並んでいるかを確かめると、差の大きさを判断できます。
費用の差は、毎回送る固定の前置きと作業の手数で決まった
費用は、APIで呼び出した3つのモデルについて、難しい45問を各社の定価で計算しています。3社とも中国の企業なので、価格は人民元です。同じモデル、同じ問題でも、エージェントによって1問あたりの費用は最大で約3倍(3.2倍)違いました。
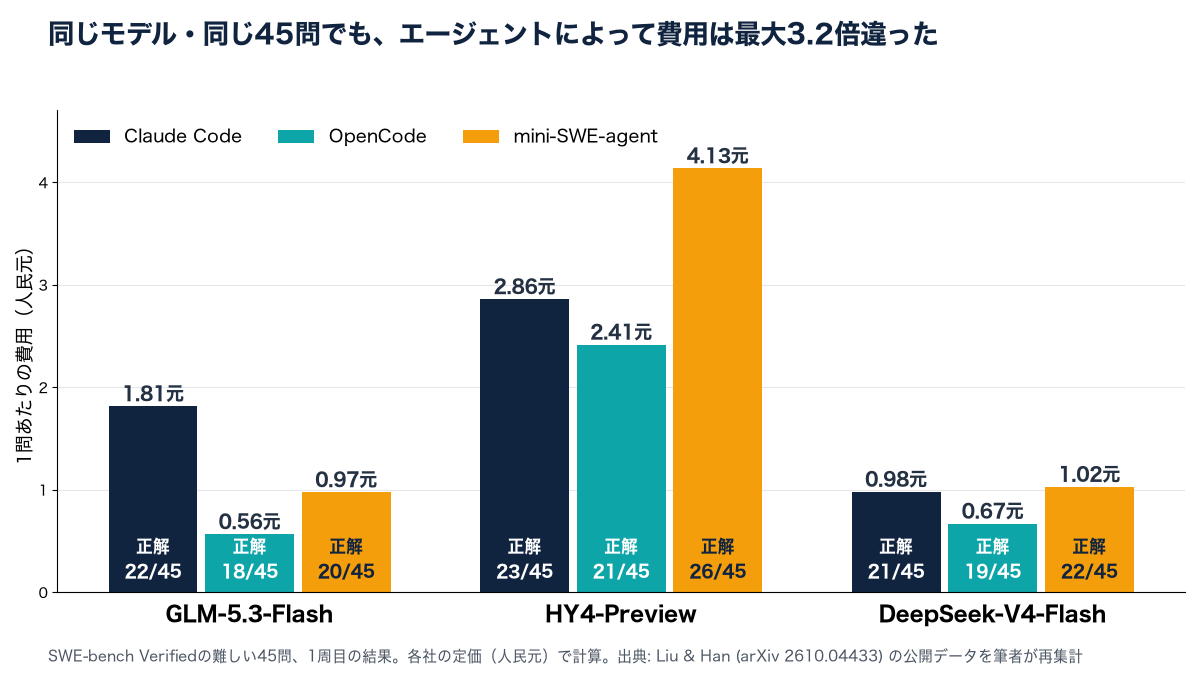
いちばん差が大きかったGLM-5.3-Flashでは、Claude Codeが1問あたり1.81元、OpenCodeが0.56元で、正解数は22問と18問でした。一方、HY4-PreviewとDeepSeek-V4-Flashでは、前置きが最も短いmini-SWE-agentがいちばん高くついています。費用は前置きの長さと、次に説明する問い合わせの回数の両方で決まります。
論文の説明では、エージェントはAIへ問い合わせるたびに、固定の前置きとそれまでの作業記録をまとめて送り直します。1問を解くあいだに問い合わせは数十回から百回以上続くため、費用はおおむね次の掛け算で決まります。
1
固定の前置き
指示文と道具の説明。問い合わせのたびに送る。
2
積み上がる作業記録
読んだファイルやコマンドの結果。手順が進むほど長くなる。
3
問い合わせの回数
1問を解き終えるまでの手数。モデルとエージェントの組み合わせで変わる。
結果
1問あたりの費用
(1+2)×3でおおむね決まる。
DeepSeek-V4-Flashでは、mini-SWE-agentの問い合わせが平均141回で、Claude Codeの104回より多くなりました。前置きは短くても回数が多いため、費用はClaude Codeを上回っています。グラフの費用は、同じ内容を繰り返し送る部分に適用される割安な「キャッシュ」料金を含めて計算しています。論文によると、キャッシュの割引率が大きく違う別の会社の価格表で計算し直しても、どのエージェントが高いかの順位は変わりませんでした。
Claude Codeの版による違いも試されています。1年前のClaude Code 1.0.100にClaude Opus 5を載せると、拡張思考(答える前に長く考える機能)が標準でオフだったため、出力は大幅に減りました。正解は45問中34問で、新しい版(2.1.263)で3回解かせた結果の35〜36問とのぶれの範囲に収まりました。論文は、版の違いで変わったのは正答率より費用だとしています。Claude Opus 5は定額プランで使ったため、論文はClaude Codeが表示する金額を実際の支払いとは扱わず、作業量の目安として比べています。
公開データから、合格数と費用を手元で計算し直した
論文の著者は、すべての試行を1行ずつ記録した表(data/trials.csv、8,032行)をGitHubで公開しています。この記事のグラフと表を作るにあたり、筆者はこの表を自分で書いた集計プログラムで読み、合格数と費用を計算し直しました。リポジトリに同梱された分析プログラムは実行せず、READMEに書かれた採点の決まり(インフラ障害の試行は除外し、各組み合わせで1周目の結果を使う)に沿って数えています。
glm-5.3-flash|hard45|claude-code: pass 22/45 (ref 22/45) | CNY/trial 1.811 (ref 1.811)
glm-5.3-flash|hard45|opencode: pass 18/45 (ref 18/45) | CNY/trial 0.562 (ref 0.562)
glm-5.3-flash|hard45|mini-swe-agent: pass 20/45 (ref 20/45) | CNY/trial 0.972 (ref 0.972)
qwen3.8-27b|pool447|opencode: pass 312/445 (ref 312/445)
...
matched 31/31
左が筆者の集計、括弧内の「ref」は論文の数値を収めた公開ファイル(reference_outputs/numbers.json)の値です。447問の6組(2つのモデル×3つのエージェント)と、45問の16組(5つのモデル×3つのエージェントと、Claude Codeだけで動かしたClaude Opus 5)を合わせた合格数22組と、3つのモデルの費用9組、合わせて31項目がすべて一致しました。論文に載った合格数と費用を公開データから同じ値で導けることを、2026年10月25日に筆者のMacで確かめています。入れ替わりの割合と必要な問題数の試算は今回計算し直していません。前置きのトークン数は、まだ公開されていない実行記録が必要なため、どちらも論文の値をそのまま使っています。
この結果が当てはまるのは、SWE-bench Verifiedで測った範囲
結果を自分の作業へ当てはめる前に、論文が測った範囲を確かめておくと判断を誤りにくくなります。
課題は1種類
PythonリポジトリのSWE-bench Verified。コマンド操作の課題(Terminal-Bench 2.1)での確認は、1モデル・50問にとどまる。
Claude Opus 5はClaude Codeだけ
3つのエージェントを同じ条件で比べたのは、Qwen、DeepSeek、GLM、HY4のモデル。
447問はQwenの2モデル
ほかの3モデルは45問だけで、13ポイントの差があっても見分けられるのは2回に1回程度。
ネットワークを遮断して実行
インターネット接続を許すと、DeepSeekとQwenの試行の71%が元の修正を取得したため、採点から外した。
思考機能の扱いも、エージェントとモデルの組み合わせで結果が変わりました。Qwen3.6-35B-A3Bで思考をオフにすると、mini-SWE-agentの正答率は11ポイント下がった一方、Claude CodeとOpenCodeの変化は偶然のぶれの範囲でした。論文は、この組み合わせの影響を今後の調査課題としています。
エージェントを選ぶ前に、自分の課題で確かめる3つのこと
今回の5つのモデルとSWE-bench Verifiedの範囲では、同じモデルを使う限り、エージェントの違いは正答率より費用と、作業が途中で止まる失敗の起きやすさに表れました。論文が勧める測り方を、自分のリポジトリで試す手順に置き換えると次のようになります。
1. 同じ課題を同じ設定で2回走らせる
2回の結果の違いが、エージェントを替えたときの違いより小さいかを先に見る。
2. 最初の問い合わせの大きさと、手数を記録する
API利用なら、利用履歴の入力トークン数と呼び出し回数を、エージェントごとに並べる。
3. 途中で止まった作業の数を数える
出力の上限や時間切れで終わった回数は、エージェントの作りで差がつきやすい。
すでにClaude Codeを使っていて、APIの従量課金で費用が気になる場合は、同じ課題を軽いエージェントでも解かせて、入力トークン数と結果を並べてみると、乗り換える価値があるかを判断できます。定額プランで使っている場合は、従量課金の費用差が支払いに直接は表れません。出力が切れたときに続きを書かせるClaude Codeの作りは、OpenCodeとの正答率の差の約半分を説明していたため、使い続ける理由の一つになります。なお、Claudeのモデルをほかのエージェントで動かした比較は、この研究には含まれていません。