
AIがニューラルネットの「重み」を読み書きしたMITの実験|Pythonなしでできたことを公開ログで整理
MITの研究チームがAIにニューラルネットワークの重みを読ませ、書き換えさせた
MITの研究者4人が2026年11月2日、OpenAIのAIモデル「GPT-6 Astra」にニューラルネットワークの「重み」を直接読ませ、書き換えさせた実験をブログ記事として公開しました。査読を経ていない、ブログ形式の発表です。ニューラルネットワークは今のAIモデルの基本となる仕組みで、重みはその中にある大量の数値です。ふつうは学習によって少しずつ決まります。研究チームは、人が数値の列を眺めて働きを読み取ることはほぼ不可能だと書いています。
発表によると、Astraは、別々のゲームを遊ぶように学習した4つの小さなネットワークについて、重みの数値を読むだけで何のゲームかを当てました。さらに、別のAIモデルの重みを編集して、数学の試験の正答率を7.9%から48.1%へ上げています。その翌日には、道具を使わなかった実験と使った実験が1本にまとまっているという指摘も出ました。
この記事では、8つの実験を使えた道具ごとに分けて整理します。研究チームが公開した実験ログから数値を集計し直し、ゲームの実験で重みに何が入っていたのかも手元で図にしました。Astra自体を動かして試したわけではなく、確かめたのはログの数値と図の再計算です。読み終えると、AIが道具なしでできたことと、Pythonやモデルの実行を使ってできたことを区別して、この研究や似た発表を読めるようになります。
3分で把握
道具なしで重みを読めたのは小さなネットワークで、大きなモデルの改善にはPythonとモデルの実行を使った
数値はすべて研究チームの公開ログと、そこから手元で再計算した結果です。
道具なしで読む
4問中4問
約1.7万個の重みから、学習したゲームを当てました。Freewayは近いゲームのFroggerと答え、正解に数えられています。
Pythonとモデルの実行を使って直す
7.9%→48.1%
約8億個の重みを持つモデルの数学の正答率。思考の堂々めぐりを減らした結果です。
うまくいかなかった実験
2種類
モデルを動かさずに「利用者の意見に合わせすぎるモデル」を見分ける実験と、堂々めぐりの少ないモデルの数学を伸ばす実験です。
8つの実験は、使えた道具がそれぞれ違う
研究チームの要約には「重みを見るだけで」という言葉が出てきますが、条件は実験ごとに違い、研究チームも本文で条件を説明しています。公開ログの説明と照らし、Honnibal氏の整理も参考に、使えた道具ごとに並べると次の表になります。
| 使えた道具 | 実験の内容 | 重みの数 | 発表された結果 |
|---|---|---|---|
| 道具なし | 1. 学習したゲームを当てる | 約1.7万 | 4問すべて正解 |
| 2. 生成する図形を当てる | 約2.4万 | 3問すべて正解(塗りつぶしの図形を輪郭で描いた) | |
| 4. 失敗する車の制御を直す | 約17万 | 失敗の記録を1回分もらい、1回の返答で修正。修正後の試行1,024回すべて成功(重みの3.5%を編集) | |
| 5. ゲームのネットワークを一から書く | 約2万 | ゲームのソースコードをもとに、1回の返答で作成(値を入れた重みは約600〜800個)。通常の学習を1億ステップ行ったネットワークを、Breakout、Seaquest、Asterixの3ゲームとも上回る | |
| Pythonで分析(モデルの実行は禁止) | 3. Python、ローマ字の日本語、英語のどれを学習したかを当てる(中間の層だけ渡す) | 約720万 | 3種類とも2回ずつ正解(確信度は48〜62%) |
| Pythonとモデルの実行 | 6. 囲碁のネットワークを一から書く | 約148万 | 実行枠50回(1回に最大128局の対局など)で、同じ大きさの学習済みネットワークを上回る |
| 7. 利用者の意見に合わせすぎるモデルを見分ける | 約2.7億 | モデルを動かさない4回の試みでは判別できず、モデルが入力のどこに注目するかを見る道具を足すと3組すべて正解 | |
| 8. 数学の正答率を上げる | 約8億(Qwen3.5-0.8B)、約2.7億(Gemma 3 270M) | Qwen3.5-0.8Bは7.9%→48.1%、Gemma 3 270Mは約1ポイント以内の変化 |
「道具なし」は、コードの実行や計算機の使用を禁じ、1回の返答だけで答えさせた実験です。途中で結果を受け取る機会がありません。Pythonを使う実験では、Astraが書いたコードを研究チーム側の隔離環境で動かし、出力を返す形を取っています。公開ログの記録では、Astraが研究チームの用意した環境の外で道具を使った形跡はありません。集計した1,125回分すべてに、組み込みの道具を呼ばなかったことを示す印が付いていました。
道具なしの実験は約17万個まで、Pythonを使う実験は約148万個以上です。大きなモデルの数値を直接読ませないのは、文字にするとAIが一度に読める量に収まらないからです。
重みを文字にしてAIへ読ませると、入力はどれくらいの量になるか
実験1:約1.7万個
約7.4万トークン
ログの実測値
実験4:約17万個
約36万トークン
ログの実測値
実験8:約8億個
17億〜34億トークン
実験1と実験4の比率から筆者が試算
トークンは、AIが文章を読むときの単位です。重み1個あたりのトークン数は実験1と実験4で約2倍違うので、実験8の値は桁の目安です。
ゲームを当てた実験では、重みの偏りが盤面の形を表していた
実験1でAstraに1回に1つずつ渡されたのは、ネットワークの重みを小数点以下3桁の文字にしたものと、入力の説明です。説明には、盤面が10×10のマス目であることと、「プレイヤー」「動く物」「報酬の的」「障害物」といった入力の種類が書かれています。ゲームの名前と選択肢は書かれていません。
ネットワークの入力は、マス目と種類の組み合わせごとに1つずつ用意されています。そのため入力につながる重みの大きさをマス目ごとに足し合わせると、学習中にどのマスが重要だったかが見えてきます。この計算は、ソフトウェアエンジニアのSean Goedecke氏が自身のブログで示した方法です。公開ログの4つのネットワークで同じ計算をして、図にしました。
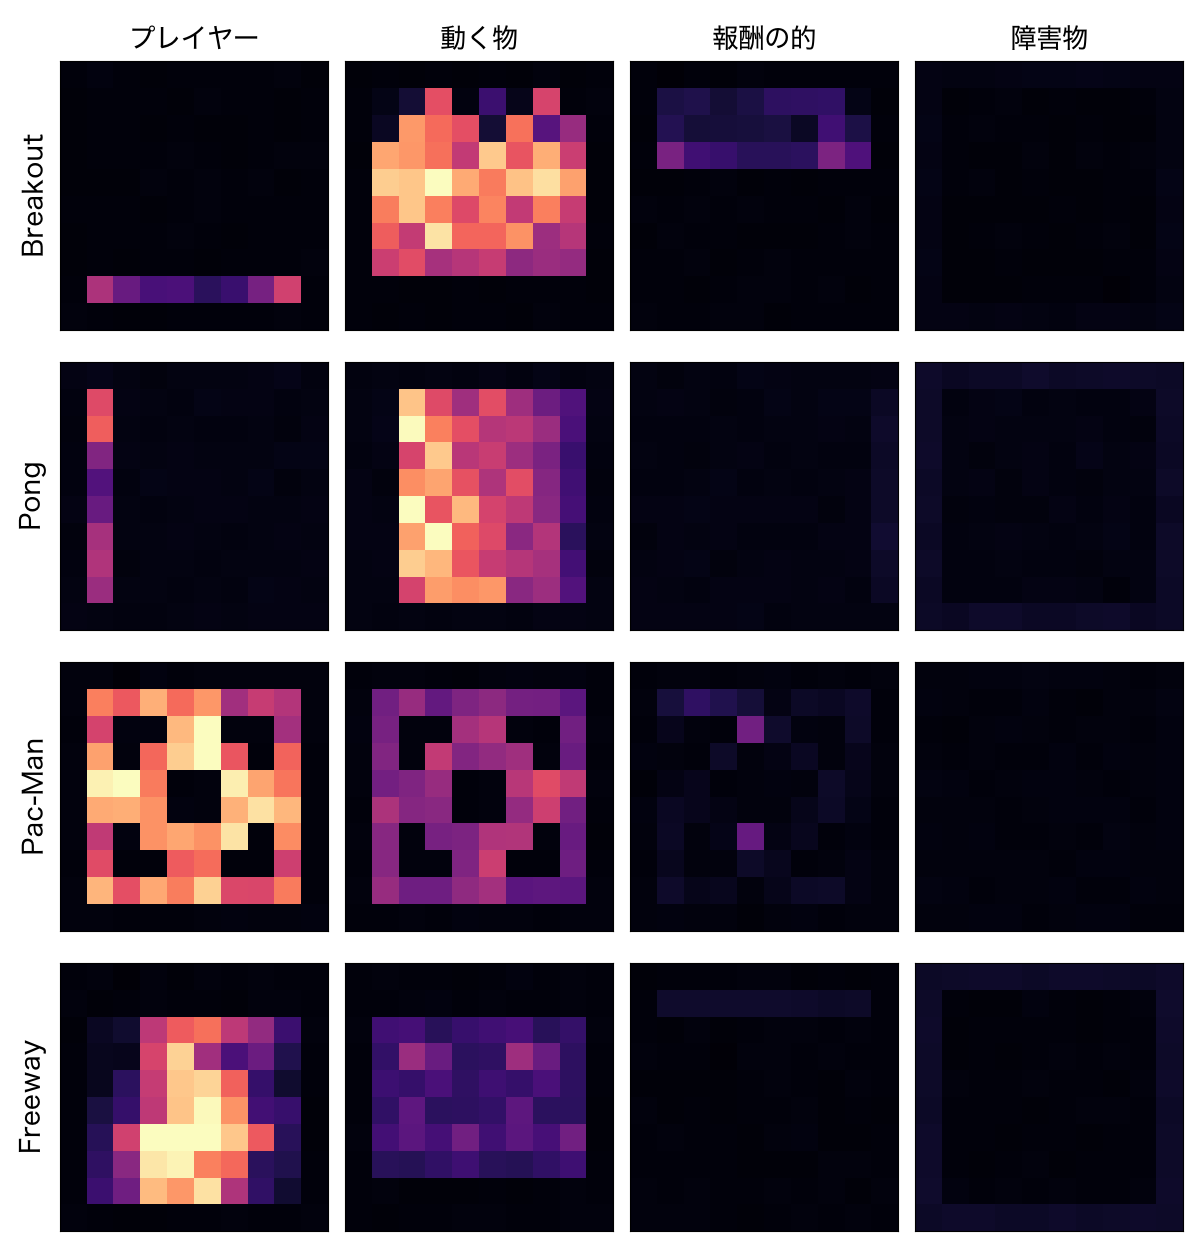
図の左端の「プレイヤー」を見ると、Breakoutでは重みが盤面の最下段に横一列で集まり、横に動くパドルと読み取れます。Pongでは盤面の左端に縦一列で集まり、Pac-Manではプレイヤーと動く物の両方に迷路の形が現れます。Freewayは中央付近に広がるだけで、この図を見てすぐに道路横断のゲームと分かる形にはなりませんでした。Astraの回答は、個々の重みの値の繰り返しや、出力層の上方向への偏りを根拠に、道路を横断するゲームと推定しています。
Astraは計算機なしで、1問あたり71〜107秒で答えました。Breakoutの回答では、プレイヤーの重みが壁のすぐ内側の最下段に集中していることを根拠に挙げています。同じ手がかりは、Goedecke氏の例のとおり3行のPythonでも取り出せます。
同じ問題を手元のノートPCで試した人もいます。Simon Willison氏は自身のブログで、17GBの公開モデルQwen 3.8 27Bに同じ問題を解かせ、1問に46〜65分かけて4問中3問を当てたと報告しました。外したのはFreewayです。手元で動く公開モデルでも、時間をかければこの課題の多くを解けたことになります。
数学の正答率が上がったのは、思考の堂々めぐりが減ったから
注目を集めた実験8の対象は、公開モデルQwen3.5-0.8Bです。このモデルには、考える過程で同じ文章を繰り返し、答えを出せなくなる癖があります。公式のモデル説明にも、推奨設定で思考のループに入りやすいという注意が書かれています。
この実験でAstraは、Pythonで重みを分析し、モデルの実行も使えました。実行は1回につき最大512問を解かせるか、最大1,024件の文章を読ませるもので、枠は10回、25回、50回の3通りです。最も結果がよかった50回の枠では、ループに関わる値のパターンを割り出し、モデルの2か所から差し引きました。編集の対象は全体の0.016%にあたる約13万個の重みです。この回にはPythonのコード実行が80回、時間が約20時間(接続待ちの約4.7時間を含む)かかりました。
モデルの実行枠と、数学の試験の結果(Qwen3.5-0.8B)
オレンジ:数学の試験MATH-500の正答率。灰色:答えの途中で上限の32,768トークンに達した割合。2つは別々に数えているので、合計は100%になりません。
編集前
正答率 7.9%
上限到達 93.0%
実行枠10回
正答率 12.3%
上限到達 87.2%
実行枠25回
正答率 14.1%
上限到達 86.4%
実行枠50回
正答率 48.1%
上限到達 33.1%
出典:公開ログの exp8_math/eval/*/merged.json。評価に使った試験問題を、Astraは作業中に見ていません。
図のとおり、正答率が大きく上がった回では上限に達した割合も大きく下がっています。Astraが試験とは別の練習問題1,152問で確かめた最終報告でも、新たに正解になった579問のうち576問は、編集前には上限で打ち切られていた答えでした。つまり実験8が示しているのは、もともと解ける問題に最後までたどり着けるようになった、という改善です。
研究チームもこの点を確かめるため、ループが少ないGemma 3 270Mで同じことを試しました。正答率は6.8%から最大7.7%までで、チームは「隠れていた能力を妨げる要因は取り除けても、持っていない能力は足せなかった」とまとめています。
評価が分かれるのは結果の解釈
実験の数値は公開ログで追えます。意見が分かれているのは、その結果が何を意味するかです。
研究チーム
重みを扱う新しいプログラミングの兆し
「Weight-Space Programming」と名付け、人間や従来の手法で期待される範囲を超える可能性があるとしています。解釈や最適化の手法を大きく変えると見ています。
Matthew Honnibal氏(spaCyの作者)
別々の手法を1つの能力に見せている
重みを直接読む実験とPythonを書く実験は分けるべきだと指摘しました。実験8の結果は機械学習の技術者もできる作業だとする一方、1〜2年前のAIモデルならできなかったとも書いています。
Sean Goedecke氏
実験の課題は優秀な研究者にもできる
モデルの改善は今後も通常の学習が中心になるという見方です。道具なしで重みを読み取った点は人間離れした暗算だとしつつ、AI研究の能力とは分けて考えています。
私がログを読んで気になったのは、実験5です。Astraはゲームのソースコードを読み、大きさ約2万個のネットワークを1回の返答で設計しました。値を入れた重みは637〜815個で、残りはゼロのままです。一度も試さずに書いたこのネットワークが、1億ステップ学習した相手を3ゲームとも上回りました。Goedecke氏は、単純なプログラムなら人でも重みに書き直せるとして深入りしていません。試す機会なしに結果を出した点は、批判を読んだあとでも見どころとして残ります。5億ステップ学習した相手と比べると、上回ったのはBreakoutだけで、SeaquestとAsterixでは届きませんでした。
似た発表を読むときに確かめる3つのこと
「AIがモデルの中身を読めるようになった」という話は、今後も増えていきそうです。実験8のような数字を見たら、次の順に確かめると、何ができるようになったのかを読み取れます。
1. AIに使えた道具は何か
「読むだけ」「Pythonで分析」「モデルを実行」のどれかで、同じ成功でも意味が変わります。Pythonとモデルの実行があるなら、技術者が行う分析と比べて評価できます。
2. 対象のモデルはどれくらいの大きさか
今回、モデルを動かさずに正解できた最大のモデルは約720万個で、3択の問題でした。約2.7億個のモデルを比べた実験7では、モデルを動かさない分析だけでは判別できませんでした。
3. 改善した原因は1つの欠点か、能力そのものか
実験8の差は堂々めぐりの解消でほぼ説明できます。上限で打ち切られた割合や、別のモデルでの結果が公開されているかを見ると判断できます。
この研究は実験ログとネットワークが公開されているので、数値を自分で確かめられます。図のような集計を試したい人は、実験1のフォルダにあるネットワークとプロンプトから始めると、数行のPythonで同じ結果を再現できます。
参考資料
- Sparks of Weight-Space Programming(Rikiya Takehi、Jayden Teoh、Alex Zhang、Omar Khattab/MIT CSAIL、2026年11月2日)。8つの実験と追加実験の発表
- lm_understand-logs(研究チーム、commit 4d09ba6を2026年11月4日に確認)。プロンプト、返答、コード、評価、ネットワーク
- The 'Astra can read and write weights to improve Qwen' post is misleading(Matthew Honnibal、2026年11月3日)。実験ごとの条件の整理と批判
- LLMs are not superhuman at reading and writing neural network weights(Sean Goedecke、2026年11月3日)。重みの集計方法とQwenの実験への評価
- Qwen 3.8 27B on my laptop can interpret model weights, too(Simon Willison、2026年11月3日)。公開モデルでの追試
- Qwen3.5-0.8Bのモデル説明(Qwen)。思考のループについての注意