
Ollamaの判定モデルで日本語の問い合わせを振り分ける|5モデルを40件で比べた正答数と、選択肢の説明の書き方
Ollamaが、文章を読んで分類と確率を返す「判定モデル」に対応
手元のパソコンでAIモデルを動かせる無料のツールOllamaが、「判定モデル」に対応しています。判定モデルは、文章を読んで、あらかじめ決めておいた選択肢のどれに当たるか、「はい」か「いいえ」か、何段階のどこに当たるかを、確率つきで返すモデルです。答えは文章ではなく確率の数字で返るので、問い合わせの振り分けやレビューの分類のように、結果をプログラムでそのまま使う処理に組み込めます。
Ollamaはv0.35.0(2026年9月29日、日本時間)で判定モデル用のAPI /v1/systemone を加え、v0.40.4(10月13日)でターミナルの ollama run からも質問できるようにしました。11月4日のv0.40.15では、AutoTrust社のモデル autotrust-jev が加わっています。Ollamaのモデル一覧には、11月8日の時点で14の判定モデルが並んでいます。
この記事は、日本語の問い合わせやレビューを、外部のAPIへ送らずに手元で振り分けたい開発者に向けたものです。架空の問い合わせ40件に正解を付け、5つの判定モデルに同じ3つの質問(担当の窓口、返金の要望、緊急度。AutoTrustの緊急度だけは6段階)をして、正答数、1件あたりの時間、メモリを比べました。コマンドとAPIの使い方、選択肢の説明の書き方、人に回す件の選び方まで、手元で確かめた結果をまとめます。
記事の要点
日本語の問い合わせの担当窓口を、9Bの2モデルは40件中38〜39件当てた
2026年11月8日、Ollama 0.40.15とApple M4・メモリ32GBのMacで、5つの判定モデルを比べた結果です。9B、3B、0.8B、322Mはモデルの大きさ(中にある数値の個数で、9Bは約90億、322Mは約3億2,000万)を表します。
窓口の正答
9Bで38〜39件、0.8Bでも35件
40件中の数です。返金を求めているかは、5つのうち4つがほぼすべて当てました。
選択肢の説明の書き方
2つの窓口に当てはまる問い合わせの行き先を書く
説明を書き分けると、40件と、書き直しに使わなかった別の20件の両方で、AutoTrust、d1、Tev1の窓口の正答が増えました。
人に回す件
確信度0.8未満を人が見る(目安)
確信度は、答えが1つの候補にどれだけ偏っているかを表す値です。9Bの2つは、60件で出た誤りがすべて0.8未満の側に入りました。
速さとメモリ
1件0.05〜3.5秒、メモリ0.6〜19GB
3問を1回で送ったときの時間と、40件を2回送った直後のメモリです。9Bの2つは2秒以上かかり、17GBと19GBを使いました。
判定モデルには、3つの型の質問をする
判定モデルへ渡すのは、判定する文章(state)と、質問(questions)です。質問ごとに型を1つ選び、答えの候補とその説明(criteria)を付けます。1回の呼び出しで、同じ文章について最大64個の質問をまとめて送れます。
質問の型と、返ってくる値
選択肢 choice
どの窓口が担当するか
候補を2〜26個、説明つきで渡します。最も確率の高い候補と、候補ごとの確率、確信度が返ります。
はい・いいえ noul
返金を求めているか
「はい」と「いいえ」に当たる状態を説明します(省略もできます)。「はい」の確率が0〜1で返ります。
段階 score
どのくらい急ぐか
段階の説明を低い順に2〜10個渡します。段階ごとの確率と、段階の番号(0から)を確率で重みづけした平均が返ります。
出典: OllamaのDecisionの文書とソースコード(2026年11月8日確認)。
確信度(confidence)は、答えが1つの候補にどれだけ偏っているかを0〜1で表す値です。Ollamaの文書は、確信度が高い答えも誤ることがあると説明しています。確信度と正答の関係は、後半で手元の結果から確かめます。
Macで判定モデルを動かすまでの手順
手元では、Homebrewで入れたOllama 0.40.15を、Apple M4・メモリ32GBのMacで使いました。公式サイトのアプリを入れた場合は、アプリがサーバーを自動で起動するので、brew install と ollama serve は要りません。ollama pull から同じ手順です。
# Ollamaを入れる(0.40.15以降)
brew install ollama

# サーバーを起動する(別のターミナルで開いたままにする)
ollama serve

# 判定モデルを1つダウンロードする(例: 1.5GBのTev1 0.8B)
ollama pull tev1:0.8b
モデルは ~/.ollama/models に保存されます。今回の5つは合計で約26GBになりました。使わなくなったモデルは ollama rm tev1:0.8b のように消せます。判定の要求は手元のサーバー(127.0.0.1:11434)へ送ります。Ollamaの文書では、文章をOllamaのクラウドで判定するのは、モデル名に :cloud を付けたときです。
ollama run --askで、問い合わせ1件を判定する
ターミナルで試すときは、判定する文章をファイルやパイプで渡し、質問を --ask で書きます。選択肢は --choice 名前="説明" で書き、段階は --level "説明" を低い順に並べます。行の右の%は、表示された答えの確率です。質問、名前、説明は日本語のままで動きました。次は「同じ注文で2回請求されています。片方を取り消して返金してください。」という1行を ticket.txt に入れて実行した結果です。
$ ollama run tev1:0.8b --ask "お客さまは返金を求めていますか?" < ticket.txt
yes  83%

$ ollama run tev1:0.8b \
    --ask "お客さまは返金を求めていますか?" \
    --ask "担当する窓口はどれですか?" \
      --choice billing="請求、支払い、返金" \
      --choice shipping="配送、届いた商品の破損" \
      --choice technical="アプリやサイトの不具合" \
      --choice account="ログインとアカウント" \
    --ask "どのくらい急いで対応すべきですか?" \
      --level "急がない" --level "早めに" --level "すぐに" \
    < ticket.txt
お客さまは返金を求めていますか?   yes      83%
担当する窓口はどれですか?      billing  99%
どのくらい急いで対応すべきですか?  早めに      43%  1.1 / 2
段階の行の 1.1 / 2 は、0〜2の段階の確率で重みづけした平均です。--choice 請求="請求、支払い、返金" のように選択肢の名前を日本語にしても、請求 99% と返りました。--format json を付けると、次の節と同じJSONが表示されます。このときの質問の名前は q1、q2 のような通し番号になります。
アプリからは、/v1/systemoneへ3つの質問をまとめて送る
アプリに組み込むときは、HTTPのAPI /v1/systemone を使います。質問に名前を付けて送ると、同じ名前で答えが返ります。次は、窓口・返金・緊急度の3問を1回で送る例です。文章は「届いたマグカップが割れていました。交換ではなく返金を希望します。」です。
curl http://127.0.0.1:11434/v1/systemone \
  -H 'Content-Type: application/json' \
  -d '{
  "model": "tev1:0.8b",
  "state": "届いたマグカップが割れていました。交換ではなく返金を希望します。",
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "この問い合わせを担当する窓口はどれですか。",
      "criteria": {
        "billing": "請求、支払い、返金、領収書",
        "shipping": "配送、届いた商品の破損や間違い",
        "technical": "アプリやサイトの不具合、エラー、表示の問題",
        "account": "ログイン、パスワード、アカウントの設定や安全"
      }
    },
    "refund": {
      "type": "noul",
      "instructions": "お客さまは返金を求めていますか。",
      "criteria": {"false": "返金を求めていない", "true": "返金を求めている"}
    },
    "urgency": {
      "type": "score",
      "instructions": "この問い合わせにはどのくらい急いで対応すべきですか。",
      "criteria": [
        "急がない:質問や要望",
        "早めに:このお客さまの手続きが止まっている",
        "すぐに:サービス全体の障害、数時間以内の期限、不正利用"
      ]
    }
  }
}'
手元で返った応答です(確率は小数第3位で丸め、段階の説明を並べ直した legend などを省きました)。
{
  "model": "tev1:0.8b",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "billing",
      "probabilities": {"billing": 0.987, "shipping": 0.011, "technical": 0.001, "account": 0.001},
      "confidence": 0.947
    },
    "refund": {"type": "noul", "noul": 0.984},
    "urgency": {
      "type": "score",
      "score": 0.427,
      "probabilities": {"0": 0.650, "1": 0.273, "2": 0.077},
      "confidence": 0.243
    }
  },
  "usage": {"input_tokens": 494, "output_tokens": 0}
}返金の要望(noul が0.984)は正しく読み取れています。一方で、窓口は確信度0.947で「請求(billing)」を選びました。届いた商品の破損なので配送の窓口に回したい問い合わせですが、配送の説明(届いた商品の破損)にも請求の説明(返金)にも当てはまり、モデルは「返金」を含む請求の説明のほうを選びました。この直し方は、後半の「説明の書き分け」の節で扱います。
Pythonから呼ぶときも、同じJSONを送るだけです。手元の比較には、標準ライブラリだけで書いた次の関数を使いました。
import json, urllib.request

def decide(model, text, questions):
    body = json.dumps({"model": model, "state": text, "questions": questions}).encode()
    req = urllib.request.Request("http://127.0.0.1:11434/v1/systemone", data=body,
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req) as r:
        return json.load(r)["answers"]

# QUESTIONS は、上のcurlの "questions" と同じ辞書
answers = decide("tev1:0.8b", "注文から1週間たっても商品が届きません。", QUESTIONS)
print(answers["team"]["choice"], answers["team"]["confidence"])
日本語40件では、9Bの2モデルが窓口を最も多く当てた
比べたのは、Ollamaの一覧から大きさと提供元が違う5つです。問い合わせは、請求・配送・アプリの不具合・アカウントの4つの窓口に10件ずつ、筆者が架空に作った40件です。返金を求める文は7件、緊急度は「急がない」14件、「早めに」20件、「すぐに」6件と正解を付けました。質問と選択肢の説明は日本語で書き、1件ごとに3問をまとめて送っています。選択肢の説明は、前の節のcurlの例と同じもの(以下「最初の説明」)です。グラフのオレンジの丸は、後の節で紹介する「書き分けた説明」での結果です。
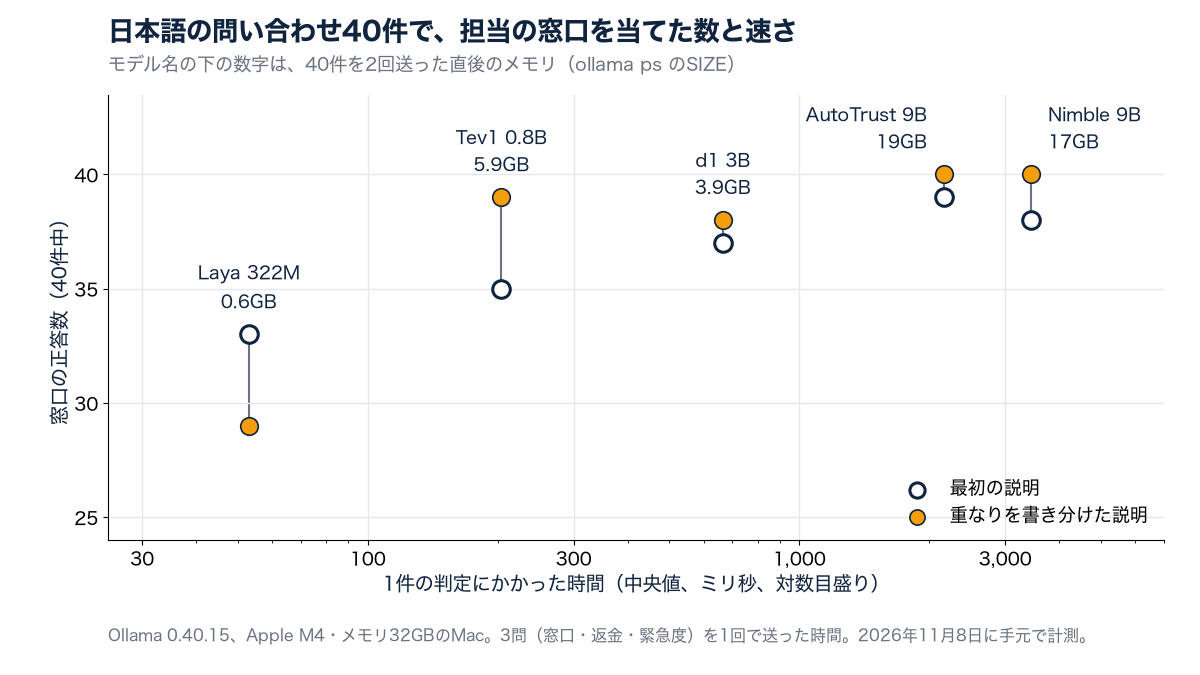
日本語の問い合わせ40件の正答数(最初の説明)
| モデル | 窓口 | 返金の要望 | 緊急度の段階 |
|---|---|---|---|
| AutoTrust 9B | 39件 | 39件 | 27件 |
| Nimble 9B | 38件 | 39件 | 27件 |
| d1 3B | 37件 | 40件 | 24件 |
| Tev1 0.8B | 35件 | 40件 | 17件 |
| Laya 322M(多言語版) | 33件 | 27件 | 9件 |
返金の要望は「はい」の確率0.5以上を「はい」として数えました。緊急度は最も確率の高い段階の正答数で、AutoTrustは6段階で聞いて2段階ずつ合わせました(理由は後述)。
動かすのに必要なもの
モデル(ollama pull の名前) | ダウンロード | 1件の時間 | メモリ |
|---|---|---|---|
AutoTrust 9B(autotrust-jev:9b) | 11GB | 2.2秒 | 19GB |
Nimble 9B(nimble:9b) | 9.3GB | 3.5秒 | 17GB |
d1 3B(d1:3b) | 3.7GB | 0.7秒 | 3.9GB |
Tev1 0.8B(tev1:0.8b) | 1.5GB | 0.2秒 | 5.9GB |
Laya 322M(laya:322m-multilingual-bf16) | 0.66GB | 0.05秒 | 0.6GB |
時間は、モデルを読み込み直してから、書き分けた説明の3問を40件送ったときの1件あたりの中央値です。メモリは、同じ40件を2回送った直後の ollama ps の値です(2回目は、同じ入力の読み込みをキャッシュで省いたモデルがあります)。ダウンロードの大きさは、Macで取得したときの値です。
窓口の振り分けは、9BのAutoTrustとNimbleが38〜39件、3Bのd1が37件、0.8BのTev1が35件を当てました。0.8Bでも9割近くを当てていて、速さを優先したい用途なら試す価値があります。返金を求めているかは、Laya以外の4つがほぼすべて当てました。Layaは、返金を求めていない33件のうち13件にも「はい」を返しました。
1件あたりの時間は、Tev1が0.2秒、d1が0.7秒、AutoTrustが2.2秒、Nimbleが3.5秒でした。Nimbleのページは、M5 Maxを積んだMacBook Proで100ミリ秒未満で答えると説明しています。手元のM4で3問をまとめて送ると、1件あたり約3.5秒でした。機種や文章の長さなどの条件が違うので、ページの数字とはそのまま比べられません。速さは、自分の機械と質問で測って確かめます。
メモリは、表の時点で9Bの2つが17GBと19GBを使いました。メモリ32GBのMacでは、9Bを動かしながらほかのアプリを開くと余裕が少なくなります。ollama ps で実行方式(RUNNER)が mlx と表示されたTev1、Nimble、AutoTrustは、使うにつれてメモリの値が増えました。読み込んだ直後はTev1が1.7GB、Nimbleが9.6GB、AutoTrustが11GBでした。Tev1は、読み込み直してから質問の書き方を変えて40件ずつ3回送ると、6.3GB、8.9GB、10GBと増えました(表の5.9GBは、同じ質問で40件を2回送ったあとの値です)。AutoTrustは、説明と問い合わせの組を変えて合わせて160件を送ったあとに20GBでした。表の値は目安にして、長く動かすときは多めに見込みます。
質問と選択肢の説明を英語に書き換えて同じ40件を送ると、最初の説明と比べて、窓口の正答はTev1が1件増え、d1は変わらず、NimbleとAutoTrustは1件ずつ減り、Layaは4件減りました。窓口の判定では、英語にして正答が増えたのはTev1の1件だけで、日本語のまま書いても大きく不利にはなりませんでした。一方で緊急度は、Tev1で英語の説明のほうが正答が多く(日本語17件、英語27件)、Layaは英語にすると返金の誤りが13件から31件に増えました。言語の影響は質問とモデルで違うので、自分の質問で両方を試します。
窓口の説明が重なる問い合わせは、行き先を書き分けると正答が増えた
40件で出た誤りを見ると、多くは選択肢の説明が2つの窓口に当てはまる問い合わせでした。「届いた商品が割れていたので返金してほしい」は、配送の説明(届いた商品の破損)にも、請求の説明(返金)にも当てはまります。「退会のページが見つからない」「二段階認証のコードが届かない」は、アカウントとアプリの不具合のどちらにも読めます。モデルは片方を選ぶので、どちらに回すかを説明に書いておく必要があります。
そこで、重なる問い合わせの行き先が決まるように、窓口の説明だけを書き直しました。窓口の質問文と、返金・緊急度の質問は変えていません。
最初の説明
billing: 請求、支払い、返金、領収書shipping: 配送、届いた商品の破損や間違いtechnical: アプリやサイトの不具合、エラー、表示の問題account: ログイン、パスワード、アカウントの設定や安全
重なりを書き分けた説明
billing: 請求額や支払い方法の問題、請求の誤りによる返金、領収書shipping: 配送の遅れや届け先、追跡番号、届いた商品の破損や間違い(その返品・返金・交換を含む)technical: アプリやサイトの不具合、エラー、表示の問題account: ログイン、パスワード、二段階認証、退会、アカウントの設定や安全
マグカップの問い合わせをTev1 0.8Bに送り直すと、窓口は確信度0.952で「配送(shipping)」に変わりました。40件全体の結果と、書き直したあとに作った別の20件の結果は次のとおりです。別の20件は書き直しの参考にしていない問い合わせで、「靴のサイズ違いの返金」「ログインボタンを押すと固まる」のように、窓口が重なりやすい文を多めに入れています。
| モデル | 40件(最初 → 書き分け) | 別の20件(最初 → 書き分け) |
|---|---|---|
| AutoTrust 9B | 39 → 40件 | 18 → 19件 |
| Nimble 9B | 38 → 40件 | 18 → 18件 |
| d1 3B | 37 → 38件 | 16 → 18件 |
| Tev1 0.8B | 35 → 39件 | 15 → 18件 |
| Laya 322M(多言語版) | 33 → 29件 | 14 → 16件 |
窓口の正答数。別の20件は、説明を書き直したあとに作った問い合わせです。
書き直した説明は、Laya以外の4つで40件の正答を増やしました。別の20件では、AutoTrust、d1、Tev1、Layaの正答が1〜3件増え、Nimbleは変わりませんでした。Tev1は40件で35件から39件になり、9Bとの差がほぼなくなりました。説明を直したら、直すときに見た問い合わせとは別の問い合わせで正答数を確かめると、たまたま40件に合わせただけの修正かどうかを見分けられます。
書き分けた説明で、別の20件のうち3つ以上のモデルが外したのは、「ログインボタンを押すと画面が固まります。パスワードは合っています。」(正解はアプリの不具合、Laya・Tev1・d1がアカウントと判定)と、「知らないうちに配送先が見覚えのない住所に変わっていて、注文もされています。」(正解はアカウントの安全。5つすべてが外し、Nimble以外の4つは配送、Nimbleはアプリの不具合と判定)でした。どちらも、文中の言葉(ログイン、配送先)に引っ張られた判定とみられます。こうした問い合わせが多いときは、説明に「ログイン画面の表示の不具合はtechnical」のような例を足すか、後で説明する確信度で人に回します。
緊急度は、d1とNimbleなら急ぐ件を上に並べる用途で使えた
3段階の緊急度を、最も確率の高い段階で正解と比べると、40件中の正答は9〜27件にとどまりました。窓口や返金より低い数字ですが、緊急度は正解の付け方そのものが人によって揺れやすい質問です。そこで、正解の段階ごとに、モデルが返した重みづけ平均(score、0〜2)の平均を比べました。
| モデル | 段階の正答(40件) | 「急がない」14件の平均 | 「すぐに」6件の平均 |
|---|---|---|---|
| AutoTrust 9B | 27件 | 0.74 | 1.34 |
| Nimble 9B | 27件 | 0.70 | 1.76 |
| d1 3B | 24件 | 0.17 | 1.30 |
| Tev1 0.8B | 17件 | 0.27 | 0.87 |
| Laya 322M(多言語版) | 9件 | 1.64 | 1.75 |
平均は、モデルが返した score(0=急がない、1=早めに、2=すぐに)の平均。AutoTrustは6段階で聞いたスコアを0〜2にそろえました。
AutoTrustは、段階の質問にちょうど6段階を求めます。3段階で聞くと、APIでもコマンドでも score criteria must contain exactly 6 levels が返り、判定できませんでした。そこでAutoTrustだけは、3つの段階をそれぞれ2つに分けた6段階で聞き、2段階ずつ確率を足して比べています。
d1 3BとNimble 9Bは、「すぐに」と付けた6件の平均が「急がない」の14件より1以上高く、スコアの高い順に並べると、上位6件に「すぐに」の6件のうち5件が入りました。この2つのスコアは、段階を1つに決めて自動で処理するより、スコアの順に並べて人が上から見る使い方に向いています。Layaは、正解の段階ごとの平均が1.64、1.71、1.75とほとんど変わらず、スコアの高い順に並べても上位6件に「すぐに」は2件しか入りませんでした。今回の40件では、Layaの緊急度に使える差は出ませんでした。
確信度の低い件を人に回すと、9Bの2つでは誤りがすべてそちらに入った
窓口の判定では、確信度が低い件を人やより大きなモデルに回すと、自動で振り分ける件の誤りを減らせることがあります。書き分けた説明で判定した40件と別の20件、合わせて60件で、確信度0.8を境目にして分けた結果です。
| モデル | 確信度0.8以上(自動で回す) | 0.8未満(人が見る) |
|---|---|---|
| AutoTrust 9B | 44件(誤り0件) | 16件(誤り1件) |
| Nimble 9B | 45件(誤り0件) | 15件(誤り2件) |
| d1 3B | 53件(誤り1件) | 7件(誤り3件) |
| Tev1 0.8B | 34件(誤り2件) | 26件(誤り1件) |
| Laya 322M(多言語版) | 41件(誤り6件) | 19件(誤り9件) |
書き分けた説明での窓口の判定。40件と別の20件を合わせた60件です。
9BのAutoTrustとNimbleは、60件中の誤り(1件と2件)がすべて確信度0.8未満の側に入りました。件数が少なく、0.8はこの60件の結果を見て選んだ境目なので、目安として使います。0.8以上の44〜45件を自動で振り分け、残りの15〜16件を人が見れば、この60件では誤りなく振り分けられます。d1は4件の誤りのうち3件が0.8未満で、人が見る件は7件で済みました。Tev1は誤りが3件と少ない一方、0.8未満の件が26件と多く、誤りのうち2件は0.8以上でした。
d1、Tev1、Layaには、確信度0.8以上でも誤った件がありました。Ollamaの文書のとおり、確信度は正しさの保証にはならないので、誤ったときの影響が大きい判定(返金の自動承認など)は、確信度が高くても人の確認を通します。境目の値は、自分の問い合わせで「自動で回す件数」と「その中の誤り」を数えてから決めます。
組み込む前に、入力の上限とライセンスを確かめる
判定モデルを実際のシステムへ入れる前に、確かめておく条件が4つあります。手元で上限を超える要求を送ったときの応答と、各モデルのページに書かれたライセンスをまとめました。
入力の長さ:64KiBまで
文章と質問の定義を合わせた上限で、1KiBは1,024バイトです。日本語はおよそ2万字までが目安で、約70KB(「あ」を2万4,000字並べた文字列)を送ると、413 と text and schema must not exceed 64 KiB が返りました。長い文章は、判定に要る部分だけを切り出して送ります。
選択肢と段階の数:モデルで違う
Ollamaの文書の上限は選択肢26個、段階10個です。Tev1は選択肢26個で Tev1 supports at most 24 candidates と返り、24個までです。AutoTrustは段階がちょうど6個のときだけ答えます。窓口が多いときは、大分類と小分類の2回に分けて聞きます。
ライセンス:商用で使うなら先に読む
Nimble、AutoTrust、LayaはApache 2.0です。d1のLFM Open License v1.0は、年間売上1,000万ドル以上の法人の商用利用を対象から外しています。Tev1は、ダウンロードして使うモデル本体(学習で得た数値の集まりで「重み」と呼ばれます)のライセンスを確定する作業中と、モデルの説明ページにあります(11月8日時点)。
言語:日本語を明記しているのはd1
d1は対応言語に日本語を挙げています。Layaのページは、多言語版を100以上の言語に対応すると説明しています。NimbleとAutoTrustの説明ページ(Hugging Faceのモデルカード)が対応言語に挙げているのは英語だけで、Tev1は英語以外を十分に評価していないと書いています。日本語で使うなら、自分の文章で正答数を確かめます。
上限は2026年11月8日にOllama 0.40.15で確認。ライセンスと言語は各モデルのページとd1のLICENSE、Tev1、Nimble、AutoTrustの説明ページによる。
v0.40.15のリリースノートは、AutoTrustのモデルの対応環境をAppleシリコンと書いています。LinuxやWindowsのサーバーで動かす予定なら、使うOllamaの版のリリースノートで対応を確かめるか、残りの4つを試します。この記事の数字はMacで計測したもので、ほかのOSでは取得されるモデルの形式が変わることがあります。
最初の1つは、動かす環境とライセンスから選ぶ
ここまでの結果から、使う場面ごとに最初に試すモデルをまとめました。どれを選んでも、最後は自分の問い合わせ20〜40件に正解を付けて、正答数と確信度の境目を確かめます。
AppleシリコンのMacで、20GB以上のメモリを使える
AutoTrust 9B:窓口の正答数が5つで最も多く(40件と別の20件の合計60件で、最初の説明では57件、書き分けた説明では59件)、Apache 2.0です。段階の質問はちょうど6段階で書きます。
LinuxやWindowsのサーバーで、Apache 2.0のモデルを試したい
Nimble 9B:手元のMac(実行方式が mlx の形式)では、正答がAutoTrustに近く、確信度0.8以上の件はすべて当てました。ほかのOSでは別の形式のモデルが取得されることがあるので、正答数と時間を自分の環境で確かめ直します。
メモリ4GB前後で、1件1秒以内に返したい
d1 3B:窓口37件、返金40件、緊急度の並べ替えも使えました。商用ならLFM Open Licenseの売上の条件を確かめます。
まず手元で仕組みを試したい
Tev1 0.8B:1.5GBのダウンロードで、0.2秒で返ります。使うメモリは、送る件数が増えるにつれて1.7GBから10GBまで増えました。製品に組み込む前に、モデル本体のライセンスが確定したかを確かめます。
試す順番は、小さいモデルで質問と選択肢の説明を固め、誤った問い合わせを見て説明を書き分け、最後に大きいモデルと正答数を比べる流れがおすすめです。Tev1では、説明の書き分けで窓口の正答が40件で4件、別の20件で3件増えました。どちらも、最初の説明でのTev1と9BのAutoTrustの差(40件で35件と39件、20件で15件と18件)と同じ幅です。
参考資料
- Ollama v0.40.15のリリースノート(2026年11月4日、日本時間): AutoTrustの判定モデルの追加と、Appleシリコンでの対応
- Ollama v0.35.0のリリースノート(2026年9月29日):
/v1/systemoneと判定モデルへの対応 - Ollama v0.40.4のリリースノート(2026年10月13日):
ollama runの--ask - Ollama「Decision」、APIリファレンス「/v1/systemone」(2026年11月8日閲覧): 質問の型、候補と段階の数、入力の上限、エラー
- Ollamaの判定モデル一覧(2026年11月8日閲覧): 14のモデル
- 各モデルのページ: Tev1、d1、Nimble、autotrust-jev、Laya(2026年11月8日閲覧): 大きさ、言語、ライセンス
- Tev1-0.8B-experimentalのモデルカード、d1-3BのLICENSE(2026年11月8日閲覧): ライセンスの状態と商用利用の条件
- Bespoke-Nimble-9B、JEV-9Bのモデルカード(2026年11月8日閲覧): 対応言語とライセンス
検証環境
- macOS 27.0.1(Apple M4、メモリ32GB)
- Ollama 0.40.15(Homebrew)、Python 3.15.2
- 検証日: 2026年11月8日
この記事は、AIが調査と下書きを担当し、上記の環境で実際に動かして結果を確かめ、下書きとは別の担当が公開前に本文と出典を確認しています。制作と訂正の方針は編集・訂正方針で公開しています。