Metaが公開したAIモデル「Muse Spark Open」|利用条件と動かすのに必要な環境
MetaがAIモデル「Muse Spark Open」の中身を公開した
Metaは2026年10月15日(米国時間)、AIモデル「Muse Spark Open」の中身を、申請すればダウンロードできる形で公開しました(Metaの発表)。プログラミングや、AIが自分で手順を組み立てて作業を進める使い方に向けたモデルで、文章に加えて画像、音声、動画も読み取れます。
Metaはこれまで、AIモデル「Muse Spark」を自社のサービスやAPIで提供してきました。今回のMuse Spark Openは、そのうちMuse Spark 1.3と同じ土台に、単体で配っても悪用されにくくする追加の学習を施したものです(PyTorchの解説)。AIの中身を決める数値(パラメータ)は8,160億個あり、文章を少しずつ書き出すたびに、そのうち420億個を選んで使います。
この記事では、Muse Spark Openを使う3つの方法、ライセンス料なしで使うための条件、自分の機材で動かすのに必要なメモリ、Metaが公開した他社モデルとの比較を順に整理します。読み終えると、APIで試すか、製品へ組み込むかを自分の条件で決められます。
3つの要点
中身を配布するMetaのAIモデル。使い方は3通りから選べる
いちばん手軽な使い方
APIで呼び出す
OpenRouterなど7社が提供。機材をそろえずに試せる。
モデルのライセンス料
無料
APIの利用料や機材費は別。製品には「Built with Muse Spark Open」の表示が必要。
自分の機材で動かす場合
軽い版でもメモリ700GB以上
Metaは最大構成のMac Studio 2台で動かす例を示した。
中身が公開されたので、使い方を3通りから選べる
AIモデルの中身は、学習で決まった膨大な数値の集まりです。この数値を「重み」と呼び、重みをファイルとして配布する形を「オープンウェイト」と呼びます。ChatGPTのように運営会社のサーバーでしか動かないモデルと比べると、オープンウェイトのモデルは、置き場所と使い方を利用者が選べます。
Muse Spark Openの場合、選べる方法は次の3通りです。
Muse Spark Openを使う3つの方法
1. APIで呼び出す
事業者のサーバーで動かしてもらう
Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AIが提供。使った分だけ料金を払う。
2. クラウドに置く
自社用のサーバーで動かす
Amazon SageMaker AI、Google Cloud Model Garden、Microsoft Foundry Modelsから重みを取り込める。
3. 自分の機材で動かす
データを外へ出さずに使う
Hugging Faceから重みをダウンロードする。利用条件への同意と、Metaによる申請の承認が必要。
提供先はMetaの発表(2026年10月15日)による。
APIは、プログラムからAIを呼び出す仕組みです。料金は「トークン」という文章の単位で数えます。OpenRouterの公開データでは、Muse Spark Openの料金は100万トークン当たり、AIへ渡す文章(入力)が1.25ドル、AIが書き出す文章(出力)が4.25ドルでした(10月18日確認)。この料金は、OpenRouterでのMuse Spark 1.3の料金と同じです。
Hugging Faceから重みを取り込む場合は、ファイルの大きさも確認しておく必要があります。Hugging Faceのファイル一覧によると、数値を細かく保存したBF16版はファイルの合計が約1,644GB、数値を粗く保存して軽くしたNVFP4版は約533GBでした。どちらもダウンロード前に申請し、Metaの承認を待つ設定になっています。
ライセンス料は無料、製品には「Built with Muse Spark Open」の表示が必要
Muse Spark Openには、Metaが独自に定めた「Muse Model License」が付いています。Hugging Faceのモデルカードに載っている要点を、できることと守ることに分けました。
Muse Model Licenseで、できることと守ること
できること
- ライセンス料なしで使う
- 追加の学習で自分の用途に合わせる
- 出力を使って別のモデルを学習させる
- 改変したモデルや、出力で学習させたモデルを配布する
- 生成した文章を使う(Metaは出力の所有権を主張しない)
守ること
- 製品の画面、説明書、Webサイト、設定画面のどこかに「Built with Muse Spark Open」と表示する。改変したモデルや出力で学習させたモデルを使う場合も同じ
- AIモデルをAPIなどで他社へ提供する場合、自社と関連会社を合わせた総売上が連続12か月で2,000万ドルを超えていれば、事前にMetaへ通知して別に契約する
- 本体や改変したモデルを配布するときは、ライセンス、利用ポリシー、著作権表示を一緒に付ける
- Metaの利用ポリシーで禁じた用途(違法行為、詐欺、兵器開発など)に使わない
- 18歳未満の人が使うことは想定していない
出典:Hugging Faceのモデルカード(2026年10月18日確認)。契約の全文はモデルページでログインすると読めます。
2,000万ドルの条件が関係するのは、AIモデルをAPIなどのサービスとして他社へ提供する場合です。米VentureBeatの整理によると、社内での利用、研究、自社のアプリやサービスへの組み込みはこの条件の対象外です。売上が2,000万ドルに届かない個人開発者が自分のアプリへ組み込む場合、確かめるのは主に表示の場所と利用ポリシーです。
自分の機材で動かすには700GB以上のメモリが要る
自分の機材でMuse Spark Openを動かすには、重みをまるごとメモリへ載せる必要があります。モデルカードの目安は、NVFP4版で700GB以上、BF16版で約2TB(約2,000GB)です。動かすときは重みに加えて、読み込んだ文章を処理するための作業用の領域も要るので、ファイルの大きさより多くのメモリが必要になります。
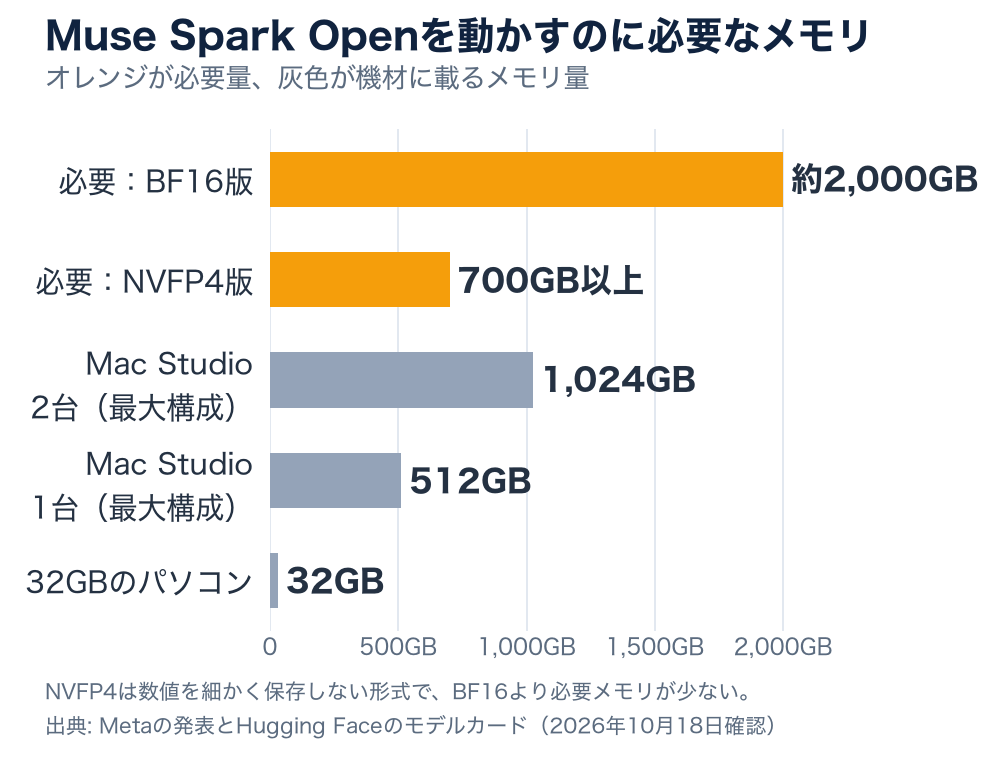
Metaが示した構成は、Apple製の高性能チップM5 Ultraを積んだMac Studio 2台をつないで1台のように使う方法です。Mac Studioは最大構成で512GBのメモリを積めるので、2台で約1TBになり、NVFP4版の目安を上回ります。Metaの発表では、この構成で、分散型SNS「Mastodon」を読み書きするオープンソースのアプリ「Ice Cubes」の不具合修正や機能追加を進めた例を紹介しています。
Metaが使ったのは発売前の機材で、512GBのMac Studioは10月下旬の発売予定、価格はまだ発表されていません(VentureBeat)。メモリ32GB前後の一般的なパソコンでは必要量に大きく届かないので、個人で試すならAPIを使う方法が現実的です。
Metaの比較表では、MCP-AtlasとJobBenchで他社モデルを上回った
Metaはモデルカードで、他社のモデル7つとの比較表を出しています。そのうち総合評価が上位のGLM 5.3、Kimi K3、Qwen3.8の3モデルと、外部のサービスや資料を使って仕事を進める課題、総合評価を抜き出しました。Muse Spark Openは2つの課題でこの3モデルを上回りました。別のツール利用の課題、コマンド操作でのプログラミング、実務の成果物の見比べ、総合評価の4つでは下回りました。
| 評価の内容 | Muse Spark Open | 他3モデルの最高 | 他3モデルで最高だったモデル |
|---|---|---|---|
| 外部サービスのツールを使って課題を解く(MCP-Atlas) | 89.2 | 84.5 | Qwen3.8 |
| 任せる優先度が高い職場の課題を資料から仕上げる(JobBench) | 61.8 | 61.4 | GLM 5.3 |
| MCPのツールを使って長い課題を解く(Toolathlon Verified) | 72.8 | 76.5 | Kimi K3 |
| コマンド操作でプログラミングの作業を進める(Terminal-Bench 2.1) | 76.4 | 85.0 | Kimi K3 |
| 44職種の実務の成果物をAIの審査役が見比べる(GDPval-AA v2) | 1,401 | 1,653 | GLM 5.3 |
| 複数のテストをまとめた総合評価(Artificial Analysis) | 39 | 45 | GLM 5.3 |
上の2行は、AIが外部のサービスにつないだツールを選んで使い、集めた情報から仕事の成果物を作る課題です。MCP-Atlasは実在の36のサービスと220のツールを使う課題集で、JobBenchは35職種から、AIへ任せる優先度が高いと判断された130件の作業を集めた課題集です。JobBenchの差は0.4点とわずかですが、調べものや資料づくりを任せる使い方では、Muse Spark Openが候補の上位に入ります。
コマンド操作でプログラミングを進める課題では、Kimi K3が85.0点で最も高く、GLM 5.3も83.9点とMuse Spark Openの76.4点を上回りました。コード中心の用途なら、Kimi K3やGLM 5.3も並べて試す価値があります。同じくツールを使う課題でも、Toolathlon VerifiedではKimi K3が76.5点、Muse Spark Openが72.8点で、課題の種類によって順位が入れ替わります。GDPval-AAは2つのモデルの成果物をAIの審査役が見比べ、その勝ち負けから付けた相対的な点数で、総合評価は第三者のArtificial Analysisが複数のテストをまとめた点数です。この2つではGLM 5.3が最も高い点数でした。比較値はすべてMetaがモデルカードに載せたもので、Muse Spark Openは答える前に考える時間を最も長くとる設定で測っています。
目的別に最初に確認すること
ここまでの内容を、目的ごとの最初の一歩にまとめました。
目的別の最初の一歩
性能を手元の作業で試したい
OpenRouterなどのAPIで、普段の調べものや資料づくりを1件頼み、いま使っているモデルと仕上がりを比べる。
自分のアプリやサービスへ組み込みたい
「Built with Muse Spark Open」を表示する画面を決め、利用ポリシーで禁じた用途に当たらないか、18歳未満の人が使うサービスかを確認する。
データを外へ出さずに動かしたい
700GB以上のメモリを用意できるかを確かめる。機材がなければ、自社で契約しているクラウド(SageMakerなど)の中で動かす方法も候補になる。
Muse Spark Openは、Metaの比較表では、MCP-AtlasとJobBenchのような資料やツールを使って仕事を進める課題で高い点数を出しました。まずはAPIで自分の作業を1件任せてみて、仕上がりと表示の条件を確かめてから、製品へ組み込むかを決めてください。
参考資料
- Meta「Muse Spark Open」(2026年10月15日):公開の内容、提供先、Mac Studioでの動作例。
- Hugging Face「Muse-Spark-Open-816B-A42B」モデルカード(10月18日閲覧):必要なメモリ、利用条件、比較表。
- PyTorch「Muse Spark Is Now an Open-Weights Model」(2026年10月15日):Muse Spark 1.3との関係、追加の安全学習。
- OpenRouter「Muse Spark Open」(10月18日閲覧):APIの料金。
- VentureBeat(2026年10月15日):利用条件の対象範囲、Mac Studioの発売時期。