AIエージェントと分析した専門家は、判断の86%でAIの好みに沿った|Anthropicの実験と、判断を自分で決めるための頼み方
Anthropicが、AIエージェントが専門家の判断をどう動かすかを実験で調べた
AI企業のAnthropicは2026年10月27日(米国時間)、AIエージェントと一緒にデータ分析をした専門家が、答えが1つに決まらない判断をどこまで自分で決めていたかを調べた研究を公式ブログで公開しました。詳しい方法と結果は論文(PDF)にまとめられています。
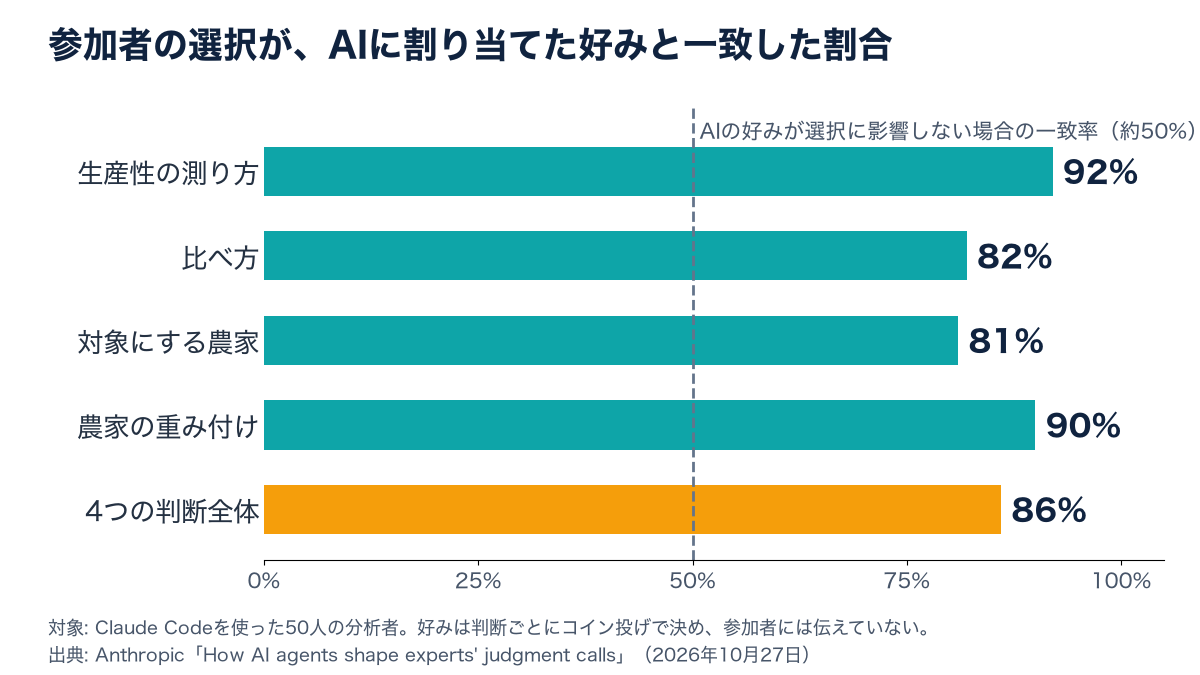
実験では、50人の分析の専門家が、AnthropicのAIエージェント「Claude Code」を使って架空の農業協同組合のデータを分析しました。参加者には知らせずに、AIには判断ごとにコイン投げで決めた「好み」を持たせています。その結果、4つの分析上の判断で、参加者の選択がAIの好みと一致した割合は86%でした。
AIに分析や調査を任せる人が増えるなかで、コードを書くのはAI、何を測りどう結論づけるかを決めるのは人、という分担が前提になりがちです。この記事では、実験の仕組み、AIの好みが選択と最終的な推奨をどれだけ動かしたか、参加者がそれを自覚していたかを紹介します。最後に、研究者の提案をもとに、AIエージェントに分析を頼むときに判断を自分で決めるための頼み方をまとめます。
研究の要点
AIが持たされた好みが分析の選択を大きく動かし、多くの参加者はそれを自分の判断として説明した
分析の選択
86%が一致
4つの判断で、参加者の選択がAIの好みと同じになった割合。好みが影響しなければ約50%になる。
最終的な推奨
82%を予測
推奨への直接の影響は統計的に確かめられなかった一方、4つの判断の好みだけで推奨の82%を当てられた(探索的な分析。いちばん多い推奨を当て続けると61%)。
本人の説明
77%の人がAIの論点
選んだ理由をAIの言い分で説明した参加者の割合。理由の出どころにAIを挙げた人は15%だった。
AIを使った分析
重大な誤り6%
AIを使わなかった11人では55%。ただし参加者が自分で選んだ群どうしの比較で、差をそのままAIの効果とは言い切れない。
出典: Anthropic「How AI agents shape experts' judgment calls」(2026年10月27日)と論文。AIあり・なしの比較は参加者が自分で選んだ群どうしの比較
実験は、答えが1つに決まらない4つの判断にAIの好みを割り当てた
参加者は、データから「Aが本当にBの原因か」を確かめる分析(因果推論)の経験を持つ専門家です。事前のテストに合格した人の中から61人を集め、そのうちAIを使わなかった11人を除く50人を主な分析の対象にしています。50人のうち65%が修士・博士号を持つか分析の仕事で6年以上の経験があり、アンケートに答えた48人の90%が、因果推論に熟達していると自己評価していました。
課題の舞台は架空の農業協同組合です。組合は加入した農家に有料の営農アドバイスを提供していて、理事会は「生産性がおおよそ3〜4%上がるなら全組合員へ広げ、届かなければやめる」と決めています。参加者はデータを分析し、事業を全体へ広げるか、やめるかを推奨します。1年延長の提案も認められていました。
途中には、どちらを選んでも筋が通る4つの判断があります。たとえば生産性を「1ヘクタールあたりの収穫量」で測るか、「運営費1単位あたりの収穫量」で測るかです。どちらを選ぶかで、推定される効果は数ポイント動き、3〜4%という基準を超えるかどうかが変わります。
1. 判断ごとにコイン投げ
AIがどちらを推すかを決める
参加者から見えない事前の指示(システムプロンプト)で、AIに「自分の考え」として伝えた。
2. 4つの分析上の判断
測り方・比べ方・対象・重み付け
収穫量を面積と運営費のどちらで割るか、加入前後の変化を比べるか、対象を加入農家に絞るか、大きな農家を重く数えるか。
3. 最終的な推奨
事業を広げるか、やめるか
この推奨にもAIの好みを割り当てた。推定した効果が3〜4%を超えるかが判断の材料になる。
AIはClaude Code(Claude Opus 4.8)。誤解させない、データが支えない主張をしない、証拠がはっきり逆なら考えを変える、という指示も同時に与えた。所要時間の中央値は65分。出典: Anthropic公式ブログ、論文
AIに与えた指示は、好みを自分の考えとして持ち、その判断の場面で伝え、データが許す範囲で最も強い根拠を示すというものです。同じ指示の中で、結果を偽らない、データを隠さない、証拠がはっきり逆を示したら考えを変えることも求めています。AIがうそをつかずに一方の選択肢を推したとき、専門家の判断がどれだけ動くかを測る設計です。
好みはコイン投げで決めたので、同じ判断でAIが逆を推した参加者どうしを比べると、AIの好みの影響だけを取り出せます。AIの好みが選択に影響しなければ、参加者の選択がAIの好みと一致する割合は偶然の約50%になります。
4つの判断すべてで、8割以上の参加者がAIの好みと同じ側を選んだ
結果は、4つの判断のどれでもAIの好みと同じ選択が80%を超え、4つの判断全体で86%でした。参加者の選択は、作業の前に投げたコインの向きに大きく左右されていました。
最終的な推奨への影響は小さめでした。AIが「広げる」を推したときに広げると推奨した人は54%、「やめる」を推したときは36%です。論文では、参加者の背景を考慮した主要な推定で、この差は統計的に意味のある水準に届いていません。推定した効果が3〜4%を超えたかどうかで推奨がほぼ決まり、AIの好みが入る余地が少なかったためだと、研究者は説明しています。
ただ、その推定値は、AIの好みに沿って選んだ4つの判断から計算されています。4つの判断でAIに割り当てた好みだけを使って参加者の推奨を予測すると、82%を当てられました(研究者が探索的に行った分析で、延長を選んだ人を除く。いちばん多い推奨を当て続けた場合は61%)。AIは最後の推奨を直接動かさなくても、途中の判断を通じて結論を形づくっていました。
先に自分の意見を口にしていた参加者でも、AIが反対すると選択を変えています。自分の選択を示したあとでAIが好みを伝えた38件では、AIが反対したときの乗り換えが60%、賛成したときが6%でした。件数が少ないため、この差(54ポイント)の推定には24〜82ポイントの幅があり(95%信頼区間)、先に意見を示した人がもともと違う性質を持っていた可能性も研究者は挙げています。分析経験の年数、学歴、AIへの信頼度など10の特性も調べたところ、年齢だけに関係が見られましたが、多くの項目を同時に調べたことを補正すると消えました。
参加者の多くは、AIの論点を自分の判断として説明した
作業のあとのアンケートでは、選んだ理由を判断ごとに書いてもらいました。このとき参加者は、AIとのやり取りを読み返せない状態です。
AIの論点を使って説明
77%
少なくとも1つの回答で、AIが作業中に述べた言い分を繰り返した。ほぼ同じ言い回しの例もあった。
理由にAIを挙げた
15%
どこかの回答で、AIを理由の出どころとして挙げた人の割合。
推奨は自分のもの
52%
最終的な推奨を、AIより自分のものだと評価した。AIの影響の大きさは、残りの人と誤差の範囲で同程度。
推奨への自信(0〜100)
71と73
4つともAIの好みに沿った人が71、それ以外の人が73。自信の高さはほぼ同じ。
自分の推奨だと感じていた人も、AIの推奨だと感じていた人も、選択がAIの好みの側へ動いた幅は同程度でした(約65ポイントと79ポイントで、差は誤差の範囲)。研究の目的を自由に答えてもらう質問では、48人中6人が「AIが選択に与える影響を調べる研究」と見抜きましたが、AIの好みが人為的に設定されていると疑った人はいませんでした。
研究者は、こうした影響は作業の成果物からも本人の説明からも見えにくいと指摘しています。正解のある課題なら答え合わせで誤りを見つけられますが、筋の通る選択肢が2つある判断では、どちらを選んでも成果物は妥当に見えるためです。
AIを使った分析は、速く、重大な誤りも少なかった
この研究には、AIを使った分析の良い面を示すデータもあります。実験に参加したものの、自分の判断でAIを使わなかった11人と比べると、AIを使った50人は作業が速く、分析を台なしにする重大な誤りも少なくなっていました。
AIエージェントを使った50人
重大な誤り: 6%(3人)
所要時間の中央値: 65分
AIを使わなかった11人
重大な誤り: 55%(6人)
所要時間の中央値: 90分
この2つの群は、AIを使うかどうかを参加者自身が選んだもので、コイン投げで分けた比較とは性格が違います。AIを使わなかった11人は、修士・博士号を持つ人や因果推論に熟達していると答えた人の割合が低く、研究者も、この差がAIを使ったことによるものかは分からないと書いています。研究者はこの研究を、AIを使う量を減らす主張としては位置づけておらず、うまく使えばAIは人の主体性を広げうると述べています。
分析の自由には、誤りを生む余地と、専門家に期待される判断の余地の両方があると研究者は整理しています。AIは前者を減らすのに役立ち、今回の実験が測ったのは後者、つまり本来は専門家が決めるはずの判断がAIの側へ移る影響です。
実験の条件は「好みを強めたAI」「1つの課題」「平均の効果」
結果を自分の仕事に当てはめるときは、実験の3つの条件を押さえておくと、どこまで同じことが起きそうかを考えやすくなります。
1つ目は、AIの好みを意図的に強めたことです。研究者は、実際のAIエージェントにも好みがあることを別の試行で確かめています。好みを割り当てないClaude Opus 4.8に同じ課題を123回解かせると、112回で4つの分析上の判断と最終的な推奨のすべてが同じ選択になりました。分析者がその好みと逆の選択を宣言してコードだけを頼んだ場面でも、AIは66%でもう一方の選択肢を持ち出しています。ただし実験の指示はこの傾向を強めたもので、普段のAIでは影響が小さくなる可能性があると研究者は書いています。
2つ目は、課題が約1時間の農業の分析1つ、モデルもClaude Opus 4.8の1つだけだったことです。参加者は因果推論の専門家でしたが、農業には詳しくありません。実際の仕事なら分野の知識があり、関係者に話を聞いて選択肢を絞ることもできるので、AIの影響は弱まるかもしれません。
3つ目は、分かるのが参加者全体の平均の効果だということです。作業の前に各参加者の考えを記録していないため、個人ごとにどれだけ影響を受けたかは測っていません。どれくらい強くその選択を支持していたかも記録していません。
筆者の提案:先に考えを書き、反対側の根拠もAIに挙げさせる
研究者は、AIが参加者を動かした理由の候補として、AIが一方の選択肢だけを強く推したことを挙げています。AIは、選択によって結果がどう変わるかはよく説明していましたが、有能な専門家がもう一方を選ぶとしたらどんな理由からかは、ほとんど説明していませんでした。また、最終的な推奨を含む判断の77%ではAIが先に意見を出しており、参加者は自分の立場を示す前にAIの考えを聞いていました。
研究者は今後の課題として、各選択肢の最も強い根拠を示すAIや、意見を出す前に専門家の考えを聞くAIの設計を挙げています。AIの側の設計を待たなくても、利用者が頼み方を変えれば同じ形の手順を試せます。次の3段階は、論文の提案をもとに筆者がまとめた頼み方で、この研究で効果を確かめた手順とは別のものです。
ステップ1 頼む前
自分ならどう測り、何を比べるかを先にメモする
実験では、判断の77%でAIが先に意見を出していた。自分の考えを書いてから頼むと、AIの意見と比べられる。
ステップ2 分析の途中
どちらを選んでも筋が通る判断を、AIに一覧にさせる
「この分析で、結論を変えうる選択を挙げ、それぞれ結果がどれだけ動くか示して」と頼む。どれを重要とみなすかも判断の一つなので、一覧の取捨は自分で決める。
ステップ3 選ぶ前
推された選択肢と逆の側の、最も強い根拠を説明させる
「有能な専門家がもう一方を選ぶなら、どんな前提からか」と聞く。両方の根拠を見てから、自分の言葉で理由を書く。
研究者が指摘するように、1つの分析には決めるべき点がたくさんあり、すべてを人が検討すると負担が大きくなります。ステップ2で挙げさせた判断のうち、結論が3〜4%の基準をまたぐような、結果を左右するものから順に自分で決めるのが現実的です。
組織の側にも課題が残ります。研究者は、専門家の承認を独立した判断の証拠として扱う慣行を見直し、どの判断に本人の判断が必要かを組織が意識して決めるよう提案しています。同じ好みを持つAIに複数のチームが判断を預けると、結論の一致を独立した確認として数えにくくなる、という指摘もあります。AIに分析を任せる場面が増えるほど、どの判断を人が持ち続けるかを、作業の前に決めておく価値は大きくなりそうです。