コマンドラインツールllmのembed-multiで日本語ファイルが文字化けしていた不具合|0.37での直し方と、作り直すファイルの見分け方
llm 0.37で、embed-multi --filesの日本語ファイルの文字化けが直った
Simon Willison氏が開発するコマンドラインツールllmは、ターミナルからAIモデルに質問したり、文章を「埋め込み」に変えて意味の近い文書を探したりできるツールです。埋め込みは、文章の意味を数値の並びで表したもので、質問と文書の近さを比べる検索に使います。
2026年11月3日(日本時間)公開のllm 0.37で、ディレクトリ内のファイルをまとめて埋め込む llm embed-multi --files の不具合が直りました。0.36までは、UTF-8で書かれた日本語のファイルを文字化けした文字列のまま埋め込み、--store を付けた場合はその文字列を保存していました。この不具合は2023年9月にIssue #283として報告され、修正のプルリクエストが0.37に入っています。コマンドはエラーも警告も出さずに終わるため、検索で目的の文書が上位に出てこないことで初めて気づきます。
この記事は、0.37より前のllmで日本語のファイルから埋め込みを作ったことがある人に向けたものです。手元のMacで、Ollamaの埋め込みモデルを使って0.36と0.37.1(翌日に出た0.37の修正版)を比べ、文字化けで日本語の検索がどれだけ外れるか、作り直しが要るファイルの調べ方、0.37以降での作り直し方を確かめました。
記事の要点
0.37以降で前回と同じembed-multiを実行し直すと、文字化けしたファイルだけが埋め込み直される
2026年11月9日、llm 0.36と0.37.1、Ollamaの埋め込みモデルembeddinggemmaで確かめた結果です。
影響する使い方
0.36までの embed-multi --files で日本語のファイルを読んだ
--encoding を付けなかった場合と、llm embed-multi --help の例どおり --encoding utf-8 --encoding latin-1 を付けた場合が当てはまります。é などを含む英語のファイルも同じです。
検索への影響
正解が1位に出た質問が、10件中1件から9件に
日本語の質問10件で比べました。0.36では、7件で英語のファイルが1位に来ました。
直し方
0.37以降に上げて、前回と同じ embed-multi を実行
文字化けしていた日本語の10件だけが埋め込み直され、ASCIIの文字だけの英語の3件はそのまま残りました。
Shift_JISのファイル
0.37以降で --encoding utf-8 --encoding cp932 を付ける
0.37.1でも、何も付けないとShift_JISのファイルは文字化けして埋め込まれます。
文字化けして埋め込まれる使い方と、文字化けのしくみ
embed-multi --files は、ファイルを読むときに文字コードを順に試します。何も指定しなければ、UTF-8、Latin-1の順です。0.36までは、UTF-8で読めたあとも次のLatin-1を試し続け、最後に読めた結果を使っていました。Latin-1はどんなバイト列でも読めてしまうため、UTF-8の日本語のファイルは、必ずLatin-1で読んだ文字化けした文字列になります。ASCIIの文字(半角の英数字と記号)だけのファイルは、UTF-8でもLatin-1でも同じ文字列になるので影響を受けません。英語のファイルでも、「Café」のé のような文字を含んでいれば、0.36までは文字化けしていました。
0.36で、日本語10件と英語3件のファイルを --store 付きで埋め込み、保存された本文の先頭をSQLiteで表示した結果です。埋め込みは、名前を付けた「コレクション」(ここでは faq)ごとに、llmの設定ディレクトリにある embeddings.db へ保存されます。場所は llm collections path で分かります。文字化けした行は、画面に表示されない制御文字を省いて載せています。
$ llm --version
llm, version 0.36
$ sqlite3 "$(llm collections path)" "select id, substr(content, 1, 12) from embeddings order by id"
coding-style-en.txt|Coding style
kaigishitsu.txt|ä¼è°å®¤ã¯
keihi.txt|çµè²»ã®ç²¾
kenshin.txt|å¥åº·è¨ºæ
password.txt|ãã¹ã¯ã¼
pc-setup.txt|æ°ããã
release-checklist.txt|Release chec
shucchou.txt|åºå¼µã®æ°
takuhai.txt|ä¼ç¤¾å®ã¦
vpn.txt|社å¤ãã
wifi-en.txt|Office Wi-Fi
yukyu.txt|æ給ä¼æ
zaitaku.txt|å¨å®å¤å
日本語の10件はすべて文字化けし、英語の3件だけが正しく保存されています。0.37.1で同じ手順を実行すると、日本語の本文がそのまま保存されます。
$ llm --version
llm, version 0.37.1
$ sqlite3 "$(llm collections path)" "select id, substr(content, 1, 12) from embeddings order by id"
coding-style-en.txt|Coding style
kaigishitsu.txt|会議室は、予約カレンダー
keihi.txt|経費の精算は、領収書の写
kenshin.txt|健康診断は毎年10月に行
password.txt|パスワードを忘れたときは
pc-setup.txt|新しいノートパソコンが届
release-checklist.txt|Release chec
shucchou.txt|出張の新幹線や飛行機は、
takuhai.txt|会社宛ての宅配便は1階の
vpn.txt|社外から社内のシステムに
wifi-en.txt|Office Wi-Fi
yukyu.txt|有給休暇は、取得したい日
zaitaku.txt|在宅勤務の日は、始業と終
日本語のファイルを埋め込んだときの結果(手元で確認)
文字化けした
- 0.36の
embed-multi --files(--encodingなし) - 0.36の
embed-multi --files --encoding utf-8 --encoding latin-1 - 0.37.1でも、Shift_JISのファイルを
--encodingなしで読んだ場合
正しく読まれた
- 0.37.1の
embed-multi --files(UTF-8のファイル) - 0.36でも
--encoding utf-8を1つだけ付けた場合 - 0.36の
llm embed -i ファイル(1件ずつの埋め込み) - 0.36の
embed-multiでCSVを読んだ場合 - ASCIIの文字(半角の英数字と記号)だけのファイル
2026年11月9日、llm 0.36と0.37.1で確認。読み込みの順番は0.36と0.37.1の embed-multi のソースコードでも確かめました。
文字化けした埋め込みで日本語の検索を試した結果
文字化けした文字列には、元の日本語の意味が残りません。検索の結果がどのくらい変わるかを確かめるため、架空の社内FAQ(経費精算、有給休暇、VPN、会議室の予約など日本語10ファイル)と、英語の説明3ファイルを用意しました。ファイルとは言い回しを変えた日本語の質問を10件作り、正解のファイルが何位に出るかを0.36と0.37.1で比べています。
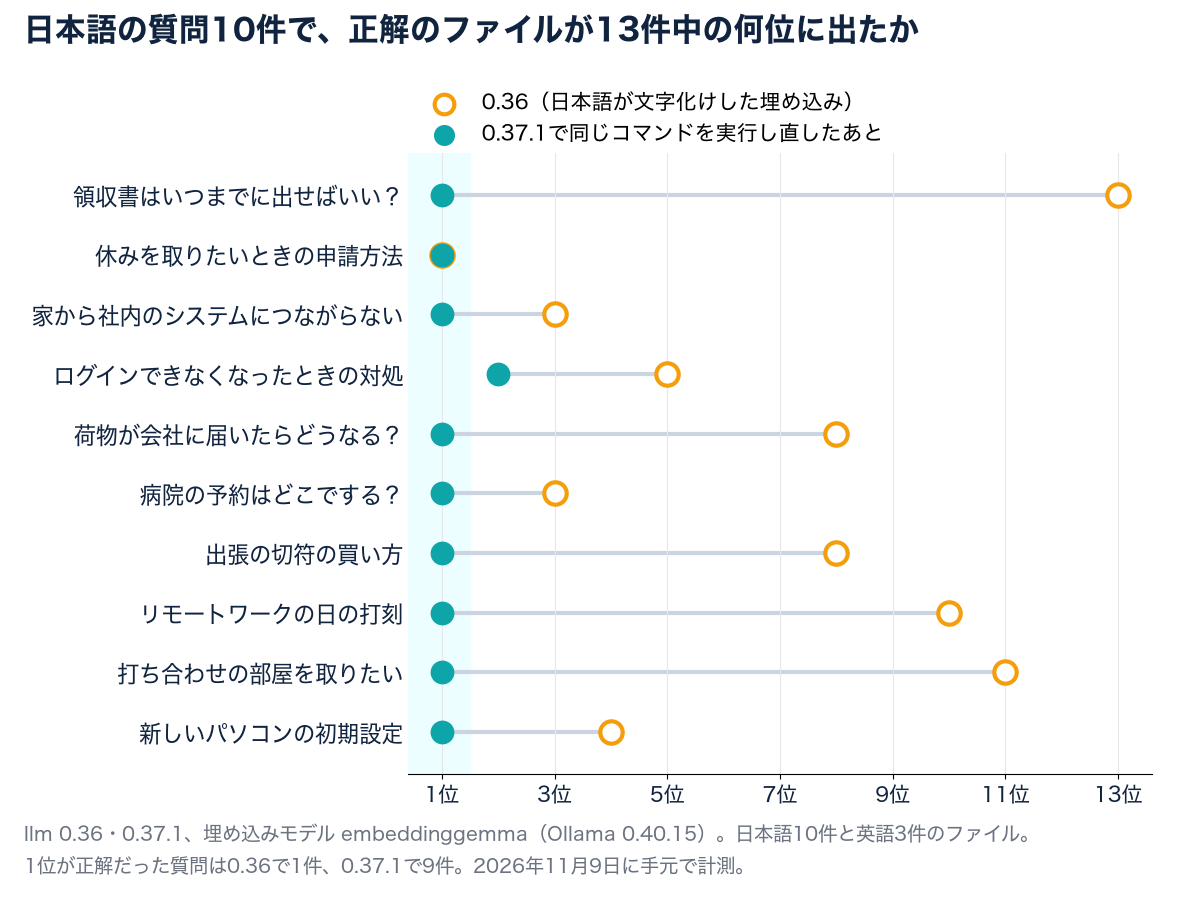
0.36では、10件のうち5件で英語のWi-Fiの説明が、2件で英語のリリース手順が1位に来ました。「領収書はいつまでに出せばいい?」の正解(経費精算のファイル)は13ファイル中13位です。0.37.1で埋め込み直すと、同じ質問で経費精算のファイルが1位になり、近さを表すスコア(最大1)も0.185から0.556に上がりました。下の出力の右の数字がこのスコアです。0.36では経費精算のファイルは13位のため、上位3件の出力には出てきません。
# 0.36で作ったコレクション
$ llm similar faq -c '領収書はいつまでに出せばいい?' -n 3 | jq -r '[.id, (.score*1000|round/1000)] | @tsv'
release-checklist.txt	0.241
coding-style-en.txt	0.238
kenshin.txt	0.232

# 0.37.1で同じコマンドを実行し直したあと
$ llm similar faq -c '領収書はいつまでに出せばいい?' -n 3 | jq -r '[.id, (.score*1000|round/1000)] | @tsv'
keihi.txt	0.556
yukyu.txt	0.407
shucchou.txt	0.332
試した手順
埋め込みモデルは、手元で動かせる無料のツールOllamaのembeddinggemmaを、llmのプラグインllm-ollamaから使いました。外部のAPIへ文章を送らずに試せます。
# Ollamaを入れて、埋め込みモデルを取得する(621MB)
brew install ollama
ollama serve            # 別のターミナルで起動したままにする
ollama pull embeddinggemma

# llmにOllamaのプラグインを入れ、モデル名を確かめる
llm install llm-ollama
llm embed-models | grep embeddinggemma

# docsディレクトリの.txtをまとめて埋め込み、本文も保存する(--store)
llm embed-multi faq --files docs '*.txt' -m ollama/embeddinggemma --store

# 日本語の質問で近いファイルを3件出す
llm similar faq -c '領収書はいつまでに出せばいい?' -n 3
0.36と0.37.1は別々のPythonの仮想環境に入れ、環境変数 LLM_USER_PATH で同じ設定ディレクトリを指定しました。0.36で作ったコレクションに、0.37.1で同じ embed-multi を実行し直しています。
作り直しが要るファイルを先に調べる方法
llmは、埋め込んだ文字列ごとに指紋のような値(MD5のハッシュ値、content_hash)を保存しています。ファイルをUTF-8で読んだ文字列と、Latin-1で読んだ文字列のハッシュ値を作り、保存された値と比べれば、どちらで埋め込まれたかが分かります。--store を付けずに作ったコレクションでも調べられ、埋め込みモデルも呼び出しません。
次のスクリプトを check_garbled.py として保存します。引数は、データベースの場所、コレクション名、embed-multi に渡したディレクトリとパターンです。embed-multi で --prefix を付けていた場合は、その値を5番目の引数に渡します。ファイルはllmと同じ読み方(改行の扱いを含む)で読むので、Windowsの改行(CRLF)のファイルも判定できます。
# check_garbled.py: llm embed-multi --files で作ったコレクションの文字化けを調べる
import hashlib, sqlite3, sys
from pathlib import Path

db, name, directory = sys.argv[1:4]
pattern = sys.argv[4] if len(sys.argv) > 4 else "*.txt"
prefix = sys.argv[5] if len(sys.argv) > 5 else ""  # embed-multi の --prefix の値
conn = sqlite3.connect(db)
row = conn.execute("select id from collections where name = ?", [name]).fetchone()
if row is None:
    sys.exit(f"コレクション {name} が見つかりません")
stored = dict(conn.execute(
    "select id, content_hash from embeddings where collection_id = ?", [row[0]]))

def md5(text):
    return hashlib.md5(text.encode("utf-8")).digest()

for path in sorted(Path(directory).glob(pattern)):
    if path.is_dir():
        continue
    key = prefix + str(path.relative_to(directory))
    try:
        utf8 = md5(path.read_text(encoding="utf-8"))
    except UnicodeDecodeError:
        utf8 = None
    h = stored.get(key)
    if h is None:
        status = "未登録"
    elif h == utf8:
        status = "OK"
    elif h == md5(path.read_text(encoding="latin-1")):
        status = "文字化け"
    else:
        status = "内容が変わった(または別の文字コード)"
    print(status, key, sep="\t")
0.36で作ったコレクションに実行した結果です。「文字化け」と出たファイルが、作り直しの対象です。OpenAIなど有料の埋め込みモデルを使っている場合は、この件数が作り直しで送り直すファイルの数の目安になります。
$ python3 check_garbled.py "$(llm collections path)" faq docs '*.txt'
OK	coding-style-en.txt
文字化け	kaigishitsu.txt
文字化け	keihi.txt
文字化け	kenshin.txt
文字化け	password.txt
文字化け	pc-setup.txt
OK	release-checklist.txt
文字化け	shucchou.txt
文字化け	takuhai.txt
文字化け	vpn.txt
OK	wifi-en.txt
文字化け	yukyu.txt
文字化け	zaitaku.txt
0.37以降で前回と同じembed-multiを実行し直す手順
作り直しの流れ
1
llmを0.37以降に上げ、llm --version で確かめる
2
前回と同じコレクション名、ディレクトリ、パターン、モデルで embed-multi を実行し直す
3
check_garbled.py で、すべて「OK」になったかを確かめる
llmのインストール手順のページにある、入れた方法ごとの更新コマンドです。Homebrewのllmは、11月9日の時点で0.37.1になっています。
# 入れた方法に合わせて、どれか1つを実行する
brew upgrade llm        # Homebrew
uv tool upgrade llm     # uv
pipx upgrade llm        # pipx
pip install -U llm      # pip

llm --version           # 0.37以降になったかを確かめる
0.37以降の embed-multi は、ハッシュ値が保存済みのものと同じファイルを飛ばし、違うファイルだけを埋め込み直します。文字化けしていたファイルは正しく読んだ文字列とハッシュ値が違うので、そのファイルだけが埋め込み直されます。手元では、日本語の10件だけ更新日時とハッシュ値が変わり、ASCIIの文字だけの英語の3件は0.36で作ったときのままでした。
# 前回と同じコレクション名、ディレクトリ、パターン、モデルで実行する
$ llm embed-multi faq --files docs '*.txt' -m ollama/embeddinggemma --store

# 文字化けが残っていないかを確かめる
$ python3 check_garbled.py "$(llm collections path)" faq docs '*.txt'
OK	coding-style-en.txt
OK	kaigishitsu.txt
OK	keihi.txt
OK	kenshin.txt
OK	password.txt
OK	pc-setup.txt
OK	release-checklist.txt
OK	shucchou.txt
OK	takuhai.txt
OK	vpn.txt
OK	wifi-en.txt
OK	yukyu.txt
OK	zaitaku.txt
すぐには0.37へ上げられない環境では、0.36でも --encoding utf-8 を1つだけ付ければ、UTF-8のファイルを正しく読めました。このとき、UTF-8で読めないファイルは「Could not decode text in file」と表示されて飛ばされます。Shift_JISのファイルが混ざる場合は、0.37以降に上げて次の節の指定を使います。
Shift_JISのファイルを読むときの --encoding の指定
0.37以降でも、何も指定しなければ読み方はUTF-8、Latin-1の順のままです。Windowsで作られた古い文書などに使われるShift_JIS(CP932)のファイルはUTF-8では読めず、Latin-1で読まれて文字化けします。先に utf-8、次に cp932 を指定して実行し直すと、正しく読めました。例のコレクション名は faq-sjis、ディレクトリは sjis です。
# 0.37.1、--encoding を付けない場合
$ llm embed-multi faq-sjis --files sjis '*.txt' -m ollama/embeddinggemma --store
$ sqlite3 "$(llm collections path)" "select e.id, substr(e.content, 1, 20) from embeddings e join collections c on c.id = e.collection_id where c.name = 'faq-sjis'"
keihi-sjis.txt|oï̸ZÍAÌû
yukyu-sjis.txt|LxÉÍAæ¾µ½

# 先に utf-8、次に cp932 を指定して実行し直した場合
$ llm embed-multi faq-sjis --files sjis '*.txt' -m ollama/embeddinggemma --store --encoding utf-8 --encoding cp932
$ sqlite3 "$(llm collections path)" "select e.id, substr(e.content, 1, 20) from embeddings e join collections c on c.id = e.collection_id where c.name = 'faq-sjis'"
keihi-sjis.txt|経費の精算は、領収書の写真を経費アプリに
yukyu-sjis.txt|有給休暇は、取得したい日の3営業日前まで0.37以降は、最初に読めた文字コードで止まります。utf-8 を先に置くと、UTF-8のファイルはUTF-8として読まれ、UTF-8で読めないShift_JISのファイルだけが cp932 で読まれます。UTF-8の日本語、Shift_JISの日本語、ASCIIの文字だけの英語のファイルを1つずつ入れたディレクトリでも、3件とも正しく保存されました。
参考資料
- llm 0.37のリリースノート(2026年11月3日、日本時間):
embed-multi --filesがUTF-8のファイルをLatin-1として読んでいた問題の修正と、同じコマンドの再実行で直せること - llm 0.37.1のリリースノート(2026年11月4日、日本時間)
- Issue #283「Foreign characters stored in content with embeddings malformed」(2023年9月18日報告)、プルリクエスト #1750: 不具合の内容と修正
- llmの文書「Embedding with the CLI」:
embed-multi、--files、--encoding、llm similar - llmの文書「Setup」: 更新のコマンド
- llm-ollama、Ollamaのembeddinggemma: 検証に使ったプラグインと埋め込みモデル
検証環境
- macOS 27.0.1(Apple Silicon)、Python 3.13.14
- llm 0.36と0.37.1、llm-ollama 0.19.1、Ollama 0.40.15(埋め込みモデルembeddinggemma)
- 検証日: 2026年11月9日
この記事は、AIが調査と下書きを担当し、上記の環境で実際に動かして結果を確かめ、下書きとは別の担当が公開前に本文と出典を確認しています。制作と訂正の方針は編集・訂正方針で公開しています。